

具体描述
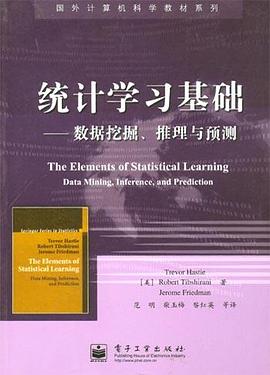
《统计学习基础:数据挖掘、推理与预测》介绍了这些领域的一些重要概念。尽管应用的是统计学方法,但强调的是概念,而不是数学。许多例子附以彩图。《统计学习基础:数据挖掘、推理与预测》内容广泛,从有指导的学习(预测)到无指导的学习,应有尽有。包括神经网络、支持向量机、分类树和提升等主题,是同类书籍中介绍得最全面的。计算和信息技术的飞速发展带来了医学、生物学、财经和营销等诸多领域的海量数据。理解这些数据是一种挑战,这导致了统计学领域新工具的发展,并延伸到诸如数据挖掘、机器学习和生物信息学等新领域。许多工具都具有共同的基础,但常常用不同的术语来表达。
作者简介
Trevor Hastie, Robert Tibshirani, and Jerome Friedman are professors of statistics at Stanford University. They are prominent researchers in this area: Hastie and Tibshirani developed generalized additive models and wrote a popular book of that title. Hastie co-developed much of the statistical modeling software and environment in R/S-PLUS and invented principal curves and surfaces. Tibshirani proposed the lasso and is co-author of the very successful An Introduction to the Bootstrap. Friedman is the co-inventor of many data-mining tools including CART, MARS, projection pursuit and gradient boosting.
目录信息
第二章 有指导学习概述
第三章 回归的线性方法
第四章 分类的线性方法
第五章 基展开与正则化
第六章 核方法
第七章 模型评估与选择
第八章 模型推理和平均
第九章 加法模型、树和相关方法
第十章 提升和加法树
第十一章 神经网络
第十二章 支持向量机和柔性判别
第十三章 原型方法和最近邻
第十四章 无指导学习
· · · · · · (收起)
读后感
评论最下面的部分Version 1是我开始读这本书的时候写的东西,现在加上点基础部分。 对linear algebra, probability 要有非常强的直观认识,对这两个基础学的非常通透。Linear algebra 有几种常用的分解QR, eigendecomposition, SVD,搞清楚它们的作用和几何意义。Bayesian meth...
评分评论最下面的部分Version 1是我开始读这本书的时候写的东西,现在加上点基础部分。 对linear algebra, probability 要有非常强的直观认识,对这两个基础学的非常通透。Linear algebra 有几种常用的分解QR, eigendecomposition, SVD,搞清楚它们的作用和几何意义。Bayesian meth...
评分非常难,一点都不element,是本百科全书式的读物,如果是初学者,不建议读 很多章节也没有细节,概述性的东西,能看懂几章就很不错了 其实每章都可以写成一本书,都可以做很多篇的论文 全部读懂非常非常难,倒是作为用到哪个部分作为参考资料查查很不错
评分对于新手来说,这本书和PRML比起来差太远,新手强烈建议去读PRML,接下来再看这本书。。我就举个最简单的例子吧,这本书的第二章overview of supervised learning和PRML的introduction差太远了。。。。读这本书的overview如果读者没有基础几乎不知所云。。但是PRML通过一个例子...
评分http://www-stat.stanford.edu/~hastie/local.ftp/Springer/ESLII_print3.pdf
用户评价
当我把这本书带到我的实战项目中去检验时,它的价值才真正体现出来。很多时候,我们在实际操作中会遇到模型性能不佳、收敛缓慢或者结果难以解释的问题,这时翻开这本书,总能在某个角落找到问题的根源所在。比如,在处理一个分类任务时,我们发现模型的召回率始终上不去,起初以为是特征工程的问题,结果翻到关于“不平衡数据学习”的那部分,作者用一种极为细致的方式解释了不同损失函数在高召回场景下的表现差异,并给出了相应的理论推导。这种“理论指导实践”的流畅衔接,是这本书最宝贵的地方。它不是一个纯粹的理论大全,也不是一本简单的工具书,它成功地架起了理论和工程实践之间的桥梁,使得我们能够带着深刻的理解去设计和调试算法,而不是盲目地堆砌技术。对于那些希望从“调参工程师”跃升为“算法架构师”的人来说,这本书无疑是必不可少的指南。
评分这本书的文字风格,说实话,初看之下有些“冷峻”,但细品之后,却能体会到一种深邃的智慧和对领域现状的深刻洞察。它不像某些流行的科普读物那样追求花哨的叙事,而是用一种近乎数学证明的精确性来描述概念,每一个论断都掷地有声,不容置疑。我特别欣赏作者在批判性思维方面的引导。书中不只是介绍主流算法,还会不时地穿插对现有方法的局限性、适用场景的探讨,甚至会指出一些公认理论中尚未完全解决的“灰色地带”。这对我个人的研究方向产生了很大的启发,因为它促使我不仅仅满足于“能用”,而是去思考“为什么这样最好”或者“是否有更好的替代方案”。读完关于正则化那一节,我像是打通了任督二脉,对于如何在高维数据中控制模型的复杂性有了全新的认识,那种豁然开朗的感觉,是其他任何材料都未能给予的。这本书更像是一部“方法论”的圣经,它教你如何像一个真正的学习者那样去思考和构建知识体系。
评分我对这本书的综合评价是:这是一部需要投入时间、但回报率极高的经典之作。它绝不是那种可以一口气读完然后束之高阁的“快餐读物”。相反,它更像是一本“工具箱”,你随着自己知识和经验的增长,会一次又一次地回到它身边,每次都能从中挖掘出新的层次和更深的理解。比如,初读时可能只关注了线性模型,但半年后当你开始接触核方法时,再回头看第一章关于向量空间和内积的定义,你会有完全不同的感悟——原来那时埋下的伏笔,是为了今天的复杂映射做铺垫。这种前后呼应的结构,让整本书形成了一个浑然一体的知识闭环。它要求读者保持专注和耐心,但一旦你付出了努力,它所赋予你的理论深度和解决问题的能力,将会成为你职业生涯中最坚实的基石之一。它值得被反复研读,并被视为该领域一座难以逾越的里程碑。
评分这本书的封面设计得很朴实,给人一种沉稳、严谨的感觉。我刚翻开目录时,就被它清晰的章节划分和逻辑严密的结构所吸引。作者似乎非常注重基础知识的铺陈,从最基本的数学概念讲起,循序渐进地引导读者进入更复杂的模型世界。比如,在介绍模型拟合和泛化误差时,作者用了大量的图示和直观的例子,这对于初学者来说简直是福音。我记得其中有一章详细探讨了偏差-方差的权衡,讲解得非常透彻,甚至连一些教科书上容易一带而过的细节,这里都给出了深入的剖析。阅读的过程中,我感觉自己不是在被动接受知识,而是在和一位经验丰富的导师进行深入的对话。它不仅仅罗列公式,更注重解释“为什么”要用这种方法,背后的思想是什么,这种对“内涵”的挖掘,让这本书的价值远超一般的参考手册。如果你想系统地打好统计学习的理论基础,这本书绝对是一个值得信赖的起点,它的深度和广度都拿捏得恰到好处,不会让人感到晦涩难懂,也不会因为过于简化而失去学术的严谨性。
评分坦白说,这本书的排版和装帧设计,虽然看起来传统,但实际上非常有利于长时间的深度阅读。纸张的质量和印刷的清晰度都属于上乘,长时间盯着公式和密集的文字也不会感到眼睛特别疲劳。更重要的是,书中的插图质量极高,那些关于决策边界、特征空间映射的示意图,都经过了精心的设计,每一个轴线、每一个阴影区域的划分,都紧密贴合数学含义,绝非那种为了填充版面而制作的敷衍图示。这种对细节的极致追求,体现了编者对读者的尊重。我习惯在书页的空白处做大量的笔记和推导,这本书的页边距设计得很合理,足够写下我的思考和疑问。这种实体书的阅读体验,是任何电子阅读器都无法替代的,它提供了一种沉浸式的学习环境,让你能够真正地“住进”这个知识体系中去。
评分: C8/6344
评分这本书实在是不好读,不过还算是可以学到点东西的
评分名为基础,实则由浅入深。看透不容易。
评分很多人反应翻译得不好,我还是以前的老观点<中文书籍可以让你快速进入一个领域>。的确里面有些词汇,并不是数学中标准的翻译。提一点:很多方法从统计的角度并不一定是最好的理解方式。继续攻读英文第二版。
评分是本好书,已出至第二版,但是这本翻译的不太好,书名译为“统计学习精要”更为合适,作者给出了各个版本的下载,不需花钱即可下载,也推荐大家看英文原版。
相关图书




本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有