
具体描述
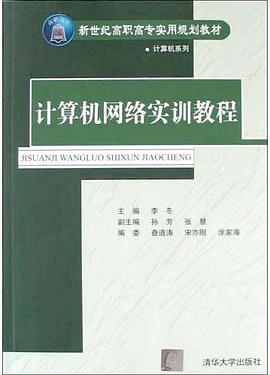
本书编写的目的是为不同专业的学生提供通用性的计算机网络实训教材,在编写体系上考虑到计算机网络课程学习的特点,兼顾了课堂理论讲述和课堂实训两方面的内容,使学生通过大量的网络实训操作,达到掌握计算机网络原理、提高网络应用技术水平的目的。
本书共分3部分,第I部分(1章-9章)包含了Internet应用的主要内容;第II部分(10章-19章)选择当前流行的网络操作系统Windows 2000 Server进行了详细介绍;第III部分(20章-22章)为组网工程实训,讲述了组网过程中的一些实用技术。
本书可作为高等院校开设计算机网络课程的相关专业的实训教材,也可作为各种不同专业网络课程的通用教材。
《数据结构与算法实战指南》 内容简介 本书旨在为读者提供一套全面、深入且高度实用的数据结构与算法学习路径,内容涵盖了从基础概念到高级应用的全过程。我们深知,扎实的数据结构和算法基础是构建高效、可维护软件系统的基石,因此,本书的设计核心在于“实战”与“深度理解”。 第一部分:基础构建与核心概念 本部分专注于奠定坚实的理论基础,并引入最常见且至关重要的基础数据结构。 第一章:算法思维的建立与复杂度分析 本章首先探讨了程序设计中的核心挑战——效率问题。我们将详细解析算法的时间复杂度和空间复杂度,重点介绍大O、大Ω和Θ记法,并辅以大量实例说明如何通过主定理和递归树方法精确分析递归算法的复杂度。我们将区分最好、最坏和平均情况下的性能分析,使读者能够批判性地评估不同算法方案的优劣。此外,本章还会引入算法设计的通用范式,如分治法的思想铺垫。 第二章:线性数据结构的深度剖析 本章详述了线性结构,这是所有复杂结构的基础。 数组与动态数组(Vector/ArrayList): 不仅讨论其底层内存布局和随机存取的高效性,还将深入探讨动态数组在扩容(Resizing)过程中的摊还分析(Amortized Analysis),揭示其看似$O(n)$的扩容操作如何保持整体$O(1)$的平均性能。 链表家族: 详细比较单向链表、双向链表和循环链表的实现细节、内存开销和操作复杂度。重点讨论链表的哨兵节点(Sentinel Node)的使用技巧,以及如何高效地进行节点插入、删除和反转操作。 栈(Stack)与队列(Queue): 分析栈的LIFO和队列的FIFO特性,并通过数组和链表两种方式实现它们。特别关注双端队列(Deque)的应用场景,如在滑动窗口最大值问题中的核心作用。 第二章的实战案例聚焦于内存管理模拟和简单的表达式求值(如使用栈进行中缀表达式转后缀表达式)。 第三章:递归、回溯与搜索策略 本章深入探讨递归这一强大的工具,并将其扩展到更复杂的搜索问题。 递归的艺术: 强调递归的基线条件、递归步骤和自我相似性。 回溯法(Backtracking): 将回溯法视为一种系统性的、带有剪枝机制的深度优先搜索。详细讲解N皇后问题、数独求解器和组合/排列生成等经典回溯问题的解题框架。本节会详细分析剪枝(Pruning)策略对性能的决定性影响。 第二部分:非线性数据结构的精湛技艺 本部分进入更为复杂和强大的非线性数据结构,这是高效算法实现的关键。 第四章:树结构:基础、遍历与应用 本章从基础的树的定义出发,系统地介绍各类树结构。 树的遍历: 彻底区分前序、中序、后序(深度优先)以及层序遍历(广度优先),并提供清晰的代码实现和应用场景对比。 二叉搜索树(BST): 讨论其基本操作(查找、插入、删除)的平均复杂度。同时,深入分析BST在极端情况下的性能退化问题,引出下一章的平衡树概念。 堆(Heap)结构: 重点讲解最大堆和最小堆的实现,尤其关注堆化(Heapify)过程的线性时间复杂度。本书将详细介绍如何使用堆来实现优先队列(Priority Queue),并将其应用于K个最小/最大元素查找问题。 第五章:平衡搜索树与高效查找 为解决标准BST的性能瓶颈,本章全面解析自平衡树。 AVL 树: 详细剖析AVL树的平衡因子概念,并以图文并茂的方式展示单旋(LL, RR)和双旋(LR, RL)的旋转操作,确保读者能够清晰掌握其维护平衡的机制。 红黑树(Red-Black Trees): 尽管实现复杂,但其在标准库(如C++ STL中的`std::map`和Java中的`TreeMap`)中的普及性要求我们必须深入理解。本章将侧重于插入和删除操作后,通过颜色翻转和旋转来维护红黑性质的规则和流程。 第六章:图论基础与遍历算法 图是建模现实世界复杂关系的最强大工具。 图的表示法: 深入比较邻接矩阵和邻接表的优缺点,特别是在稀疏图和稠密图场景下的性能差异。 图的遍历: 详尽对比广度优先搜索(BFS)和深度优先搜索(DFS)在图结构上的应用。讨论BFS如何用于寻找最短路径(无权图),以及DFS在连通分量识别、拓扑排序中的作用。 拓扑排序: 重点介绍Kahn算法(基于入度)和DFS算法两种实现拓扑排序的方法,并阐述其在任务调度中的应用。 第三部分:高级算法范式与优化技术 本部分聚焦于解决复杂问题的核心算法设计模式,这是从“会写代码”到“写好代码”的关键飞跃。 第七章:贪心算法与动态规划 本章将两种强大的优化策略进行对比和深入分析。 贪心算法(Greedy Algorithms): 阐述贪心选择性质和最优子结构。通过活动选择问题、霍夫曼编码等经典案例,强调如何证明一个贪心策略的正确性,并指出其局限性。 动态规划(Dynamic Programming, DP): 强调DP的两大核心要素:最优子结构和重叠子问题。我们将从自底向上(Bottom-Up,表格法)和自顶向下(Top-Down,带备忘录的递归)两种视角,系统解决背包问题(0/1和完全背包)、最长公共子序列(LCS)和矩阵链乘法等核心问题。特别关注状态定义和状态转移方程的构建技巧。 第八章:最短路径与最小生成树 本章集中处理图论中的优化问题。 单源最短路径: 详细解析迪杰斯特拉算法(Dijkstra's Algorithm)的原理和实现,重点是利用优先队列优化其效率。随后,深入探讨Bellman-Ford算法,及其在处理负权边和负权环检测中的关键作用。 多源最短路径: 介绍Floyd-Warshall算法,理解其基于动态规划的松弛操作,及其计算所有节点对最短路径的能力。 最小生成树(MST): 彻底讲解Prim算法和Kruskal算法,并对比两者在不同图结构下的性能表现,重点在于如何应用并查集(Disjoint Set Union, DSU)结构来高效地实现Kruskal算法。 第九章:高级搜索技术与图匹配 A搜索算法: 作为BFS的智能升级版,本章详述A算法如何利用启发式函数(Heuristic Function)引导搜索方向,实现更快速的路径查找,尤其在地图导航中的应用。 最大流与最小割: 介绍Ford-Fulkerson方法,并重点实现基于增广路径的Edmonds-Karp算法,理解网络流在匹配问题和资源分配中的抽象建模能力。 第十部分:散列与字符串算法 本章关注高效数据检索和文本处理技术。 散列表(Hash Table): 深入探讨散列函数的构造原则(如乘法法、除法法)。详细分析冲突解决策略:链式法(Separate Chaining)和开放寻址法(Open Addressing,线性探测、二次探测、双重散列),并对不同策略的性能进行实证分析。 字符串匹配算法: 不仅限于朴素算法,本章将重点介绍KMP(Knuth-Morris-Pratt)算法,通过构建LPS(最长前缀后缀)数组来避免不必要的字符回溯,实现线性时间复杂度的匹配。 附录:高级数据结构选讲 本附录简要介绍更高阶的数据结构及其应用,为有志于深入研究的读者提供方向:B/B+ 树在数据库索引中的作用,以及Trie树在字典查找中的高效性。 本书的特点在于每一章节都配有大量实际编码示例(使用主流语言实现),并提供了针对性的算法挑战题,鼓励读者边学边练,真正将理论转化为解决实际工程问题的能力。本书不仅仅是一本工具书,更是一本培养高级算法思维的实战手册。
作者简介
目录信息
第1部分 Internet应用
第1章 Internet基础
第2章 Internet网络连接
第3章 上网浏览
第4章 电子邮件
第5章 文件传输与下载
第6章 使用远程登陆与BBS
第7章 网络商务通信的实际应用
第8章 常用软件
第9章 网页制作
第2部分 Windows 2000 Server
第10章 Windows 2000 Server实训环境的构建
第11章 Windows 2000基础
第12章 计算机用户账户及活动目录管理
第13章 共享文件夹
……
· · · · · · (收起)
第1章 Internet基础
第2章 Internet网络连接
第3章 上网浏览
第4章 电子邮件
第5章 文件传输与下载
第6章 使用远程登陆与BBS
第7章 网络商务通信的实际应用
第8章 常用软件
第9章 网页制作
第2部分 Windows 2000 Server
第10章 Windows 2000 Server实训环境的构建
第11章 Windows 2000基础
第12章 计算机用户账户及活动目录管理
第13章 共享文件夹
……
· · · · · · (收起)
读后感
评分
评分
评分
评分
评分
用户评价
评分
评分
评分
评分
评分