
具体描述
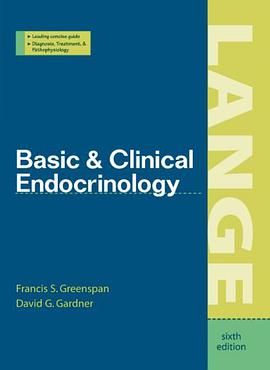
Here is absolutely everything medical students need to know about biostatistics and quantitative methods as applied to medicine, clinical practice, and research. Case study approach introduces problem
作者简介
目录信息
读后感
用户评价
阅读这本书的过程,我体验到了一种独特的“挑战后的满足感”。它不是那种读完后能让你立刻在工作中找到几个现成公式套用的速成手册,它的价值在于塑造你对数据和不确定性的理解框架。其中关于“统计功效”(Statistical Power)的讨论部分,给我留下了极其深刻的印象。作者没有把功效作为一个独立的小节敷衍了事,而是将其贯穿于实验设计、样本量估算以及结果解释的始终。他强调了“没有功效的统计显著性是毫无意义的”,这个观点在很多初级教材中经常被弱化,但在本书中却被提升到了核心地位。这种对研究科学性根源的关注,使得这本书不仅仅是一本关于“如何计算”的书,更是一本关于“如何正确地设计和解释研究”的指南。每当我在处理一个实际问题感到困惑时,翻回这本书中查找相关的理论基础,总能找到支撑我决策的坚实论据。它强迫你思考,为什么我们要选择这个检验而不是那个?如果我的数据不满足正态分布,我应该怎么办?这种对底层逻辑的执着追问,是这本书最宝贵之处,它培养的是一种批判性的统计思维,而非机械化的操作技能。
评分这本书的排版和结构设计,充分体现了其作为一本严肃学术著作的定位。它不是那种为了迎合市场而设计得花里胡哨的教材,而是遵循了经典的学术书籍的范式——清晰、功能至上。章节之间的过渡非常自然,每一个新的主题都是建立在前一个主题扎实的基础之上的,阅读起来能清晰地感受到知识体系的内在联系。我特别喜欢它在讲解复杂模型时,常常会穿插一些现实世界的案例分析,尽管这些案例的背景信息被高度抽象化,但它们有效地将抽象的统计概念与实际的科学研究场景连接了起来。例如,在讨论生存分析时,书中不仅仅罗列了Kaplan-Meier曲线的公式,还详细分析了删失数据的处理方式,这对医学研究背景的读者来说,简直是雪中送炭。此外,书中的习题部分,设计得相当有深度,它们往往不是简单的套用公式,而是要求读者对理论进行批判性思考,比如让你去判断在特定研究设计下,哪种统计检验更具鲁棒性。完成这些习题的过程,与其说是考试,不如说是一种深层次的思维训练,让你真正把统计学的工具内化为自己的分析能力,而不是停留在表面。
评分这本书的语言风格,可以被形容为“精确到冷峻”。它很少使用修饰性的词汇,一切都以信息的传递效率为最高准则。对于习惯了口语化和亲切教学方式的读者来说,初次接触可能会觉得有些疏离,甚至略显枯燥。然而,一旦你适应了这种高效的表达节奏,你会发现它的魅力所在。作者在处理像多重比较校正(Multiple Comparison Correction)这类容易引发混乱的主题时,表现出了惊人的清晰度。他通过对比不同的校正方法(如Bonferroni, Holm等)在控制I类错误和维持检验功效之间的权衡,清晰地揭示了每种方法背后的统计哲学差异。这种对比分析非常具有启发性,它让读者明白,统计决策从来都不是非黑即白的,而是充满了权衡和取舍。对我来说,这本书最大的贡献在于,它成功地将那些原本感觉像是“黑箱操作”的统计步骤,通过严谨的数学逻辑,还原成了可理解的科学推理过程。它不是一本让你读完就束之高阁的书,而是一本在你每一次进行严肃数据分析时,都会忍不住想翻开核对细节的“工具箱兼理论基石”。
评分说实话,这本书的阅读体验更像是在进行一次高强度的思维体操训练,而不是一次轻松的知识吸收。它的行文风格极其凝练,几乎没有一句废话,每一个句子都承载着特定的信息量,仿佛每一个词都是精心挑选后放置在那里的。我尤其欣赏它在引入新概念时所采取的渐进式策略。它不会一下子抛出一个宏大的理论框架让你无所适从,而是从最基础的描述性统计开始,小心翼翼地搭建起理解概率分布的基石。但这种小心翼翼并非意味着简单化,恰恰相反,它在基础之上构建的速度非常快。比如,当讲到方差分析(ANOVA)时,作者迅速地将焦点从简单的t检验扩展到了多因素模型的构建,并且非常细致地解释了交互作用项的统计学意义。这种深入浅出的能力,让那些原本觉得统计学高不可攀的人,也能在克服了初期的畏难情绪后,发现其中的美妙。不过,这种风格也对读者的预备知识提出了较高的要求,对于没有微积分基础或者对代数运算感到吃力的读者来说,可能需要花费大量时间去消化那些推导过程。我个人觉得,这本书更适合作为一本进阶参考书,而非初学者入门的“友善向导”。它更像是那位要求严苛但内心正直的导师,用最直接的方式告诉你真相,尽管真相往往是复杂的。
评分这本书,光是拿起它翻开扉页,那种沉甸甸的学术气息就已经扑面而来,感觉就像是直接闯进了一个充满了严谨逻辑和复杂模型的殿堂。我当时的想法是,这玩意儿肯定不是给那些只满足于走马观花的人准备的,它要的是那种愿意啃硬骨头、享受解构复杂问题的学习者。 拿到书后,首先映入眼帘的是它那密密麻麻的公式和图表,坦率地说,第一次看进去的时候,我的脑子是有些懵的。它不会像某些通俗读物那样,用各种生动的小故事来“引诱”你进入主题,而是直接把你丢到问题的核心。比如,关于假设检验那一章,它没有过多渲染什么“我们如何避免犯错”,而是直接深入到P值的计算、置信区间的构建,以及这些数学工具背后的哲学基础。我记得有一部分内容,专门讨论了非参数检验与参数检验之间的选择标准,那部分内容组织得极其缜密,每一步推导都像是环环相扣的锁链,逻辑严密得让人不敢轻易跳过任何一个符号。作者显然非常推崇清晰的数学表达,这一点从他对各种统计模型(比如线性回归的假设条件)的阐述中可以看得出来,每一个前提条件都被掰开了揉碎了讲,而不是简单地列举几个名词。这本书的价值,就在于它敢于直面统计学的复杂性,不回避那些让人头疼的数学推导,而是将其作为理解深层原理的必经之路。如果你想知道一个统计方法“为什么”是那样运作的,而不是仅仅记住“如何使用”它,那么这本书绝对能满足你的求知欲。
评分 评分 评分 评分 评分