
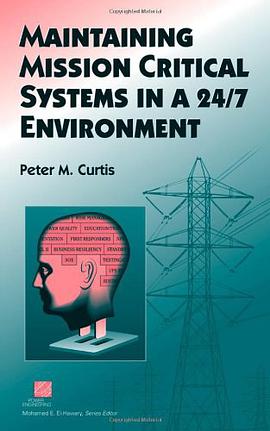
Maintaining Mission Critical Systems in a 24/7 Environment pdf epub mobi txt 电子书 下载 2026
- 系统维护
- 高可用性
- 24/7运维
- 故障排除
- 灾难恢复
- IT基础设施
- 运维管理
- 服务连续性
- 关键系统
- 可靠性工程

具体描述
The latest tested and proven strategies to maintain business resiliency and sustainability for our ever-growing global digital economy
Here is a comprehensive study of the fundamentals of mission critical systems, which are designed to maintain ultra-high reliability, availability, and resiliency of electrical, mechanical, and digital systems and eliminate costly downtime. Readers learn all the skills needed to design, fine tune, operate, and maintain mission critical equipment and systems. Practical in focus, the text helps readers configure and customize their designs to correspond to their organizations' unique needs and risk tolerance. Specific strategies are provided to deal with a wide range of contingencies from power failures to human error to fire. In addition, the author highlights measures that are mandated by policy and regulation.
The author of this text has worked in mission critical facilities engineering for more than twenty years, serving clients in banking, defense, utilities, energy, and education environments. His recommendations for maintaining essential operations are based on firsthand experience of what works and what does not.
Most chapters in this text concentrate on an individual component of the mission critical system, including standby generators, automatic transfer switches, uninterruptible power supplies, and fuel, fire, and battery systems. For each component, the author sets forth applications, available models, design choices, standard operating procedures, emergency action plans, maintenance procedures, and applicable codes and standards. Extensive use of photographs and diagrams illustrates how individual components and integrated systems work.
With the rapid growth of e-commerce and 24/7 business operations, mission critical systems have moved to the forefront of concerns among both private and public operations. Facilities engineers, senior administrators, and business continuity professionals involved in information technology and data center design should consult this text regularly to ensure they have done everything they can to protect and sustain their operations to reduce human error, equipment failures, and other critical events. Adapted from material the author has used in academic and professional training programs, this guide is also an ideal desktop reference and textbook.
作者简介
目录信息
读后感
用户评价
说实话,我刚翻开这本书时,有点担心内容会过于偏向某个特定的技术栈,毕竟“24/7”意味着可能涉及从遗留系统到最新云原生架构的方方面面。但事实证明,我的担忧是多余的。作者的视野非常广阔,他似乎对每一种主流技术平台下的挑战都有所涉猎。例如,在谈到灾难恢复(DR)策略时,他并没有固守传统的异地数据中心模式,而是详细对比了跨区域云部署的成本效益分析,甚至触及了边缘计算对高可用性架构的影响。阅读过程中,我发现自己不断地拿起笔在空白处做笔记,因为书中的许多观点都直接激发了我对现有架构的质疑和改进思路。特别值得称赞的是,书中对“韧性工程”的定义,远超出了简单的冗余备份,它强调的是系统在遭受攻击或故障后,能够自我修复、迅速恢复到可接受服务水平的能力。这种前瞻性的视角,让这本书的保质期显得格外长久,它不仅仅是解决当下问题的工具书,更是未来架构师的必备参考。
评分这本书的封面设计着实抓人眼球,那种深邃的蓝色调配上简洁有力的字体,一下子就让人感觉到了专业和沉稳。我是在一个技术交流会上偶然看到它被推荐的,当时我对“24/7环境下的系统维护”这个主题非常感兴趣,因为我们公司正面临着类似的高压挑战。这本书的排版非常清晰,每一章的结构都设计得逻辑性很强,即便是面对如此复杂的主题,也能让人感到条理分明。初读起来,作者的语言风格非常直接,没有太多冗长或晦涩的学术术语,更多的是基于实战经验的阐述。比如,它在开篇就深入探讨了什么是真正的“关键任务”,以及在现代企业中,这种不间断运行的要求是如何重塑IT运维的思维模式的。我特别欣赏作者对风险评估模型的那一部分论述,它不仅仅是罗列工具或流程,而是深入剖析了如何在瞬息万变的业务需求中,建立一个既灵活又可靠的风险应对框架。对于那些需要在高可用性和快速迭代之间找到平衡点的技术经理来说,这本书无疑提供了一个非常实用的起点。它不是那种停留在理论层面的教科书,而更像是一本由资深工程师手把手教你如何应对真实世界混乱局面的操作指南。
评分这本厚重的书籍,读完之后留给我最深刻的印象是其对“维护即开发”这一核心理念的深度挖掘。它并非简单地将运维视为开发完成后的一种“善后工作”,而是将其提升到与产品创新同等重要的战略地位。在探讨技术债务积累与清理的章节中,作者提出了一个非常有洞察力的观点:在24/7的环境下,技术债务的利息是按秒计算的,而不是按月或按年。这个比喻极其形象地说明了为何必须将系统健康纳入日常迭代周期。书中的图表设计堪称典范,它们不是为了美观而存在的装饰品,而是高度浓缩的信息载体。尤其是关于系统变更窗口和影响分析的矩阵图,我立刻截屏发给了我的同事们,因为它精准地概括了我们过去几周在一次大型升级中遇到的所有痛点。总而言之,这本书提供了一个全面的、多维度的视角来审视高可用性系统的复杂性,它成功地将技术细节、管理策略和人员心理熔铸成一个无缝的整体,是真正意义上的行业里程碑著作。
评分这本书的语言风格可以说是独树一帜,它带着一种沉稳的、近乎老派工程师的严谨感,但同时又充满了对技术进步的热情。我最欣赏它在处理“人员因素”时的坦诚。在许多运维书籍中,人往往被简化为一个执行命令的节点,但这本书却花费了大量的篇幅来讨论团队协作、知识传承和应对疲劳的策略。作者用一种近乎故事化的方式,描述了在凌晨三点半,当所有自动警报都失效时,值班工程师的心理压力和决策过程。这种对人机交互和组织心理学的关注,使得这本书的实践价值大大提升。我甚至觉得,这本书更应该被HR部门和团队领导者阅读,因为它清晰地阐述了如何在确保系统稳定运行的同时,维护团队的士气和专业性。书中提供的那些关于轮班优化和知识交接文档模板的建议,都是经过血与火的考验后提炼出来的精华,极具操作指导意义。
评分这本书的深度实在令人惊讶,它成功地避开了许多同类书籍中常见的、那种浅尝辄止的概述性描述。我尤其关注到其中关于“预防性维护与预测性维护的哲学差异”那一章。作者用一个生动的比喻,将两种维护策略比作在高速公路上行驶的车辆,一个是定期进站保养,另一个则是实时监测引擎温度和轮胎压力,随时准备干预。这种深入到方法论层面的探讨,让我对如何优化我们现有的工单分配和资源调度有了全新的认识。此外,作者在讨论自动化和人工干预的界限时,表现出了极高的成熟度。他没有盲目推崇“全自动化”的乌托邦愿景,而是坦诚地指出了在面对“黑天鹅”事件时,人类的直觉和经验是多么不可或缺。书中提供的那些详细的故障树分析案例,虽然复杂,但每一步的推导都无可挑剔,读起来像是在跟随一位顶级侦探破解一个复杂的谜题。这本书的价值在于,它不仅告诉你“该做什么”,更重要的是,它让你理解“为什么这么做”,从而建立起更坚实的系统思维。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有