
A Unified Framework for Video Summarization, Browsing and Retrieval pdf epub mobi txt 电子书 下载 2026
- 视频摘要
- 视频浏览
- 视频检索
- 多媒体
- 机器学习
- 深度学习
- 计算机视觉
- 信息检索
- 视频分析
- 人工智能

具体描述
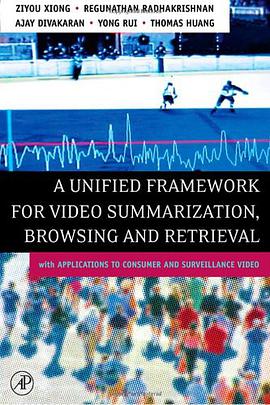
Large volumes of video content can only be easily accessed by the use of rapid browsing and retrieval techniques. Constructing a video table of contents (ToC) and video highlights to enable end users to sift through all this data and find what they want, when they want, are essential. This reference puts forth a unified framework to integrate these functions supporting efficient browsing and retrieval of video content. The authors have developed a cohesive way to create a video table of contents, video highlights, and video indices that serve to streamline the use of applications in consumer and surveillance video applications. The authors discuss the generation of table of contents, extraction of highlights, different techniques for audio and video marker recognition, and indexing with low-level features such as color, texture, and shape. Current applications including this summarization and browsing technology are also reviewed. Applications such as event detection in elevator surveillance, highlight extraction from sports video, and image and video database management are considered within the proposed framework. This book presents the latest in research and readers will find their search for knowledge completely satisfied by the breadth of the information covered in this volume. It offers the latest in cutting edge research and applications in surveillance and consumer video. It features a presentation of a novel unified framework aimed at successfully sifting through the abundance of footage gathered daily at shopping malls, airports, and other commercial facilities. It is concisely written by leading contributors in the signal processing industry with step-by-step instruction in building video ToC and indices.
作者简介
目录信息
读后感
用户评价
我被这本书中那种对“用户体验”近乎偏执的关注所深深打动。很多技术书籍往往止步于算法的完美实现,而这本书的作者显然走得更远,他们没有忘记技术的最终目的是服务于人。阅读关于“交互式摘要生成”的部分时,我仿佛能看到一个未来化的工作站界面,用户可以像指挥家一样,轻松地调整摘要的侧重点和长度。作者对人机协同的探讨非常深入,他们提出的反馈机制设计,巧妙地利用了人类的直觉判断来纠偏复杂的机器学习模型,这种务实的态度令人钦佩。这种对应用层面的关注,使得这本书的价值远远超出了纯粹的学术讨论范畴,它更像是一份指导行业实践的蓝图。我甚至开始思考,如何在我的日常工作中,借鉴这种以用户为中心的框架来优化我们现有的信息提炼流程。
评分这本书的语言风格在技术著作中算是相当富有感染力的,它在保持专业性的同时,巧妙地融入了作者对领域的热爱和思考。尤其是在总结部分,作者那种对未来挑战的坦诚以及对研究社区的期许,让人感受到一种强烈的使命感。我注意到作者在引用文献时,不仅列出了经典的开创性工作,还非常细致地补充了近年来那些鲜为人知但极具潜力的创新点,这显示了作者广博的知识面和极高的信息敏感度。整个阅读过程更像是一场高水平的学术研讨会,而不是单向的知识灌输。那种对细节的尊重,比如对不同数据集特性的微妙差异的精确描述,都体现了作者严谨的治学态度。这本书的厚度本身就是一种宣言,它告诉读者,这是一个值得投入时间去精读的深度资源。
评分这本书的章节组织结构实在令人称道,逻辑的严密性几乎无可挑剔,仿佛是一场精心编排的交响乐。从基础的视频表示理论,到复杂的时序建模,再到最终的用户交互界面设计,每一步都承接得自然流畅,没有丝毫的突兀感。我特别喜欢作者在探讨特定算法时所采用的对比分析手法,他似乎总能找到当前主流方法的阿喀琉斯之踵,然后不遗余力地展示出新方法的优越性,这种批判性思维贯穿始终。读到关于跨模态检索的那一章时,我甚至停下来,在白纸上画了几个架构图,试图完全掌握作者所提出的那种多层次特征融合机制。文字的密度很高,但行文的节奏感把握得极好,读起来并不觉得枯燥,反而有一种攀登知识高峰的酣畅淋漓。对于那些希望从理论层面透彻理解视频理解底层逻辑的工程师来说,这本书无疑是一份详尽的路线图。
评分这本书给我最大的触动在于其“统一性”的追求。在当前的视频分析领域,摘要、浏览和检索往往是割裂的三个独立子领域,各自发展出不同的技术栈。然而,这本书却以一种极具穿透力的洞察力,将这三者用一个核心的、优雅的数学框架统一了起来。这种跨领域的整合能力,简直是教科书级别的范例。我过去在尝试解决相关问题时,总是陷入于不同模块之间的兼容性泥潭,这本书提供的解决思路,像是突然点亮了一盏明灯,让我看到了如何构建一个更具内聚性和扩展性的系统。它不仅仅是技术上的整合,更是一种思维方式的转变——从局部优化转向整体最优。这种宏观层面的把握,使得这本书对于任何试图构建下一代多媒体信息处理系统的架构师来说,都是一份不可多得的参考指南。
评分这本书的封面设计着实抓人眼球,那深邃的蓝色调配上流动的光影效果,一下子就让人联想到数据洪流中捕捉精彩瞬间的复杂过程。我拿到书时,首先被它沉甸甸的质感所吸引,这通常预示着内容的深度和广度。我尤其欣赏作者在引言部分所展现出的那种宏大叙事感,仿佛带领我们站在一个制高点上,俯瞰整个视频处理领域的全景图。那种对现有技术瓶颈的精准剖析,以及对未来发展方向的雄心勃勃的展望,立刻激起了我深入阅读的欲望。它不像许多技术书籍那样晦涩难懂,反而用一种近乎哲学的思辨方式,将看似冰冷的算法与人类理解信息的需求巧妙地融合在一起。那种对“什么是好的摘要”的重新定义,对我这个长期在媒体分析领域摸爬滚打的人来说,简直是醍醐灌顶。我感觉作者在试图构建的不仅仅是一个技术框架,更是一种全新的信息消费范式。
评分 评分 评分 评分 评分相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有