
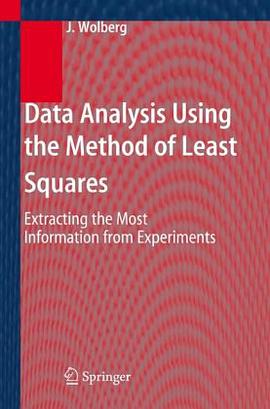

具体描述
The preferred method of data analysis of quantitative experiments is the method of least squares. Often, however, the full power of the method is overlooked and very few books deal with this subject at the level that it deserves. The purpose of Data Analysis Using the Method of Least Squares is to fill this gap and include the type of information required to help scientists and engineers apply the method to problems in their special fields of interest. In addition, graduate students in science and engineering doing work of experimental nature can benefit from this book. Particularly, both linear and non-linear least squares, the use of experimental error estimates for data weighting, procedures to include prior estimates, methodology for selecting and testing models, prediction analysis, and some non-parametric methods are discussed.
作者简介
目录信息
读后感
用户评价
这本书的封面设计真是直击人心,那种深邃的蓝色调配上简洁的白色字体,立刻给人一种专业而沉稳的感觉。我拿到手的时候,光是掂量它的分量就能感受到内容的扎实。说实话,我之前对这类数据分析的书籍都有点望而却步,总觉得充斥着晦涩难懂的公式和抽象的理论,但这本书的排版和章节划分非常人性化。作者似乎非常懂得初学者的痛点,每一步的推导都像是耐心的老师在身边手把手地教导,用词遣句也尽量避免了过度的学术腔调。尤其欣赏的是它在引入新概念时,总会穿插一些非常贴近实际应用的案例。比如,在讲解如何处理时间序列数据时,它没有停留在理论层面,而是展示了如何用这些方法去预测未来的销售趋势,这让我立刻觉得这些知识点“活”了起来,不再是纸面上的符号。我个人比较偏爱那种能提供清晰路线图的教程,而这本书恰恰做到了这一点,它没有试图一口气塞给你所有知识,而是精心设计了一个循序渐进的学习路径,让人在不知不觉中就构建起了坚实的理论框架和实践能力,这种学习体验是极其宝贵的。
评分阅读这本书的过程中,我最大的感受是作者在平衡“深度”与“广度”上的高超技巧。它既没有肤浅地停留在工具的使用层面,也没有陷入纯粹的数学推导泥潭,而是找到了一个非常完美的交汇点。对于那些想深入了解底层原理的读者来说,书中的数学推导部分提供了足够的细节,保证了理论上的严谨性,而且作者在关键步骤还会用脚注或者侧边栏的形式对一些重要的定理进行补充说明,这对于想深究的读者来说是巨大的福利。反过来说,对于那些更偏向应用、希望快速上手的读者,书中的代码示例部分做得也极其出色。每一个示例都配有清晰的注释,而且这些代码片段不仅仅是孤立的程序块,它们被巧妙地嵌入到具体的业务场景描述中,让你清楚地知道“我写下这段代码是为了解决什么问题”。我甚至尝试着把书中的一个关于市场细分(Market Segmentation)的案例代码,稍微修改了一下变量名和输入数据,结果完美运行,这种即时的反馈感,是其他很多理论性书籍无法给予的。
评分这本书的语言风格有一种奇特的魅力,它不像是冰冷的说明书,更像是一位经验丰富的老前辈在跟你分享他的职业生涯中的心得体会。它的语气里透露出一种对数据科学领域的热情和敬畏。在讨论一些具有争议性的统计学观点时,作者展现了极高的客观性,他会清晰地列出不同流派的观点和各自的优缺点,然后引导读者自己去思考,而不是强行灌输某一种“标准答案”。例如,在讨论模型选择时,那种关于偏差与方差权衡的讨论,被描述得如同哲学思辨一般引人入胜。这种开放式的探讨,极大地激发了我作为读者的批判性思维能力。我发现自己不再只是被动地接受信息,而是开始主动地质疑、比较和整合书中的观点。这种思维上的提升,对我个人职业发展的影响,甚至可能超过了单纯学会一两个新算法本身。这本书真正做到的,是教会你如何“像一个数据分析师一样思考”。
评分从装帧和细节处理上,这本书也体现了出版方对读者的尊重。纸张的质量非常好,长时间阅读也不会让眼睛感到疲劳,这对于一本需要反复查阅参考的书来说至关重要。更值得一提的是,这本书的索引部分做得极其详尽和实用。我经常需要快速定位到某个特定的术语或公式,以前找书里的内容就像大海捞针,但这本书的索引将关键词的关联性考虑得非常周到,不仅列出了术语出现的页码,还标注了它在哪个章节的上下文环境中被提及,这极大地提高了查找效率。另外,书的后记部分也写得非常真诚,作者提到了他在撰写过程中遇到的挑战,以及对未来数据分析领域发展的展望,这让人感觉自己像是参与了一场漫长的学术旅程的见证者。总的来说,这是一本从内容到形式都无可挑剔的典范之作,它不仅是一本工具书,更像是一本能陪伴你成长、不断启发你的良师益友。
评分这本书的章节逻辑安排简直是教科书级别的典范,它构建了一个非常严密的知识体系框架,这一点让我这个习惯了结构化学习的人感到异常惊喜。不同于市面上那些零散堆砌知识点的书籍,它从最基础的数据采集和预处理开始,稳步过渡到核心的建模技术,再到最后的模型评估和优化,每一步都环环相扣,没有明显的跳跃感。我特别留意了它在引入复杂算法时的处理方式。作者没有直接抛出高阶的数学表达,而是先用非常直观的语言描述了该算法背后的核心思想和解决的问题,这极大地降低了阅读门槛。我记得有一章专门讲了如何识别和处理数据中的异常值,那一段的描述简直是生动形象,作者引用了几个金融市场中因数据清洗不当而导致的决策失误的“反面教材”,瞬间让我明白了数据质量对后续分析结果的决定性影响。这种将“为什么要做”和“怎么做”紧密结合的叙事手法,让阅读过程充满了探索的乐趣,让人忍不住想一口气读完,去看看下一个环节又会揭示什么样的工具或技巧。
评分 评分 评分 评分 评分相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有