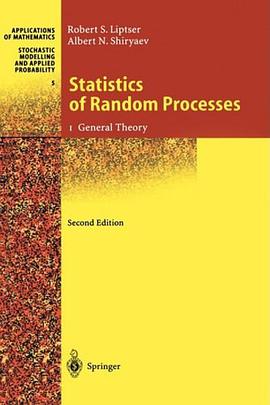

Statistics of Random Processes II

Statistics of Random Processes II pdf epub mobi txt 电子书 下载 2026

☆☆☆☆☆
出版者:Springer
作者:Robert S. Liptser
出品人:
页数:428
译者:
出版时间:2000-12-12
价格:USD 113.00
装帧:Hardcover
isbn号码:9783540639282
丛书系列:
图书标签:
  • 数学
  • 随机过程
  • 概率论
  • 统计学
  • 随机分析
  • 马尔可夫过程
  • 平稳过程
  • 时序分析
  • 信息论
  • 排队论
  • 仿真
想要找书就要到 图书目录大全
立刻按 ctrl+D收藏本页
你会得到大惊喜!!

具体描述

好的,以下是为您量身定制的图书简介,专注于不包含《Statistics of Random Processes II》核心内容的领域,深入探讨了与之形成鲜明对比的统计学和随机过程分支。 --- 概率与不确定性:从经典推断到现代算法的基石 一本深入探讨统计学在结构化数据分析、非参数推断以及复杂系统建模中作用的权威著作。 内容导览:超越时间序列的统计科学 本书旨在为读者提供一个坚实的统计学基础,该基础聚焦于静态数据结构、模型检验、高维数据处理以及非参数方法的精妙应用,从而与侧重于时间依赖性和连续时间过程的随机过程理论(如马尔可夫链、布朗运动的深入分析)形成明确分野。我们关注的是如何从有限的、可能存在复杂相互依赖性的观测样本中,可靠地提取信息、做出推断和进行决策。 第一部分:概率论的坚实地基与经典推断范式 本部分重建了现代统计学赖以生存的概率论核心,但侧重点在于离散和有限样本空间下的推断问题,而非连续随机场的精确测度论构建。 第1章:随机变量的精细刻画 我们详细考察了超越标准正态、泊松分布的混合分布模型和截断分布在实际数据拟合中的应用。重点讨论了矩量生成函数在特定结构下的局限性,并引入了更稳健的特征函数在非独立同分布(Non-IID)样本分析中的作用。概率的累积函数(CDF)和概率密度函数(PDF)的精确估计方法,尤其是在数据点稀疏区域的插值与平滑技术,是本章的核心。 第2章:参数估计的稳健性 本章深入探讨了极大似然估计(MLE)之外的替代方案。详细分析了在模型设定存在误差(Model Misspecification)时,矩估计(Method of Moments, MoM)、贝叶斯后验均值估计的性能。特别关注M-估计量和L-估计量的数学性质,它们如何通过特定的损失函数定义,抵抗异常值(Outliers)的干扰,提供比传统最小二乘法更稳定的参数估计。 第3章:假设检验的非参数化路径 抛弃对底层分布形态的先验假设,本部分完全转向非参数统计。我们详尽分析了秩统计量(Rank Statistics)的构建原理,包括Wilcoxon 秩和检验、Kruskal-Wallis 检验的渐近性质。重点演示如何利用经验过程(Empirical Processes)的理论来构建强大的Kolmogorov-Smirnov 检验和Anderson-Darling 检验,以检验数据的拟合优度,而不依赖于特定的随机过程演化模型。 第二部分:高维结构分析与维度灾难的应对 随着数据维度的爆炸式增长,传统基于欧氏距离和线性假设的方法开始失效。本部分聚焦于从高维数据中分离信号与噪声的结构化方法。 第4章:判别分析与分类理论 本章详细阐述了线性判别分析(LDA)和二次判别分析(QDA)的理论框架,强调其基于协方差矩阵的假设。随后,我们转向更具鲁棒性的支持向量机(SVM)的核方法(Kernel Methods),讨论如何通过再生核希尔伯特空间(RKHS)将非线性可分数据映射到高维空间,解决复杂的模式识别问题,这与随机过程的遍历性分析是截然不同的数学领域。 第5章:因子分析与主成分的几何解释 本章深入研究主成分分析(PCA)的几何学意义,即如何在数据方差最大的方向上进行投影。我们侧重于如何利用特征值分解来理解数据内在的低维流形结构,以及如何通过因子分析(Factor Analysis)来分离可观测变量中的共享因子与特有误差。此处的重点是数据的协方差结构在静止状态下的分解,而非其在时间轴上的演化。 第6章:稀疏建模与正则化推断 在现代统计应用中,数据维度远超样本数量($p gg n$)成为常态。本章探讨了Lasso (Least Absolute Shrinkage and Selection Operator) 和 Ridge Regression 的数学原理。重点分析 $L_1$ 范数惩罚项如何实现变量的自动选择和模型系数的稀疏化,这是一种对模型复杂度的显式控制,与随机过程中的条件期望和鞅论证处于不同的数学分支。我们讨论了 最优收缩参数的选择准则。 第三部分:统计推断的现代计算方法 本部分不再依赖于解析解或渐近理论,而是转向模拟和迭代方法,解决那些计算上难以处理的统计问题。 第7章:蒙特卡洛方法在积分与估计中的应用 本章详尽介绍拒绝采样 (Rejection Sampling) 和 重要性采样 (Importance Sampling) 技术。重点在于如何设计高效的提议分布,以准确估计高维积分,特别是在计算复杂模型(如混合效应模型)的边际似然函数时。这与随机过程模拟中的马尔可夫链蒙特卡洛 (MCMC) 存在理论上的交集,但本章的应用场景更侧重于静态后验分布的数值逼近。 第8章:贝叶斯推断的迭代求解 我们将贝叶斯方法视为一种处理不确定性的结构化框架。本章的核心是吉布斯采样 (Gibbs Sampling) 和Metropolis-Hastings 算法。我们侧重于如何构建合适的转移核来探索后验分布的复杂形态,如何评估收敛性诊断(如 Gelman-Rubin 统计量),以及如何解释和总结迭代产生的样本链,以得出稳健的参数区间估计。 第9章:模型选择与信息准则 在多个候选模型中进行选择,是统计建模的关键一步。本章全面评估赤池信息准则 (AIC)、贝叶斯信息准则 (BIC) 及其在不同惩罚机制下的理论基础。我们对比了基于信息论的模型选择与基于交叉验证 (Cross-Validation) 的预测性能评估方法,旨在找到最具有解释力和预测力的模型结构,而避免过度依赖随机过程的长期平稳性假设。 --- 本书面向读者: 统计学研究生、数据科学家、应用数学研究人员,以及任何希望深入理解静态数据结构分析、非参数推断和高维建模的专业人士。它提供了一个强大且全面的统计工具箱,专注于从数据中提取可靠的、不受时间序列结构约束的洞察。

作者简介

目录信息

读后感

评分☆☆☆☆☆

评分☆☆☆☆☆

评分☆☆☆☆☆

评分☆☆☆☆☆

评分☆☆☆☆☆

用户评价

评分☆☆☆☆☆

我最近翻阅的这本《复杂系统中的非线性动力学分析》简直是打开了我对随机现象理解的新世界。这本书的深度和广度都超出了我对“统计”类书籍的一般预期。它直接跳过了传统教科书中那些平铺直叙的基础内容,直奔主题,探讨了诸如混沌理论、分岔分析以及Langevin方程在描述复杂系统演化中的应用。作者在介绍随机过程时,采用了大量的微分方程和偏微分方程工具,对于那些习惯了线性思维的读者来说,挑战性十足,但也收获颇丰。书中对布朗运动的深入剖析,不仅仅停留在维纳过程的定义上,而是将其置于物理学和金融工程的宏大背景下进行考察,展示了随机性如何驱动宏观尺度的复杂行为。尤其令人印象深刻的是,它对马尔可夫链蒙特卡洛(MCMC)方法的理论基础进行了严谨的论证,而不是简单地介绍算法步骤。这本书更像是一部面向研究人员的专著,需要读者具备扎实的数学功底才能完全领会其精妙之处。

评分☆☆☆☆☆

这本《信息论与随机过程的交汇点》提供了一个非常独特的视角来审视随机现象。它不是传统意义上的概率论教材,而是将香农的信息理论框架与随机过程的数学结构有机地融合在一起。书中对熵的定义及其在信息度量上的作用进行了深入阐述,并将熵的概念扩展到了随机过程的各种测量中,例如互信息和互信息率。作者巧妙地利用信息论的工具来分析随机信号的传输效率和噪声抑制能力,这使得原本抽象的随机过程,有了一个清晰的“量化”标准。例如,在讨论平稳随机过程的谱密度时,书中引用了维纳-辛钦定理,并通过信息熵的视角对其进行了重新解读,极大地提升了对傅里叶分析在随机信号处理中地位的理解。这本书的价值在于它构建了一种跨学科的桥梁,对于通信、机器学习等领域的研究者来说,它提供了更深层次的理论基石。

评分☆☆☆☆☆

读完《时间序列分析:从ARIMA到GARCH模型精讲》,我才真正体会到对“时间结构”进行建模的艺术性。这本书的重点非常明确,就是围绕着数据点之间依赖关系展开。与那些泛泛而谈的统计书不同,它对经典的时间序列模型,如自回归(AR)、移动平均(MA)以及它们的组合(ARMA),进行了非常细致的分解和辨识。作者对于如何诊断序列的平稳性、如何通过自相关函数(ACF)和偏自相关函数(PACF)来确定模型阶数,描述得细致入微,几乎可以当作一本操作手册来使用。尤其是在处理金融数据时,引入的ARCH和GARCH族模型,对刻画波动率聚集现象的解释力极强,这对于量化分析师来说是极其宝贵的。书中对模型假设的检验和残差分析的强调,体现了严谨的科学态度,提醒读者模型选择并非一蹴而就,而是需要反复迭代和验证的过程。

评分☆☆☆☆☆

这本《统计学导论:从理论到实践》确实是一本令人耳目一新的入门教材。它没有那种枯燥的纯理论堆砌,而是巧妙地将概率论的基础知识与实际应用场景紧密结合起来。开篇对描述性统计的讲解就非常到位,作者用生动的例子,比如疫情数据的分析,帮助我们理解均值、方差这些基本概念的实际意义,而不是仅仅停留在公式层面。更值得称赞的是,书中对大数定律和中心极限定理的阐述,避免了过多复杂的数学推导,而是着重强调了它们在统计推断中的核心作用,这对于初学者来说,无疑降低了理解的门槛。我特别喜欢作者在讲解假设检验时所采用的“决策制定”的视角,将统计思维融入到日常问题解决的框架中,让人感觉统计学不再是高不可攀的象牙塔知识,而是触手可及的工具。全书的行文流畅自然,图表清晰直观,配合着配套的R语言实战环节,使得理论学习与技能培养完美结合,强力推荐给所有希望系统性掌握统计学基础的读者。

评分☆☆☆☆☆

很少有书能像这本《贝叶斯统计与计算方法》这样,让我对概率的理解发生根本性的转变。它以一种近乎哲学思辨的方式,彻底颠覆了我过去对频率学派统计的固有看法。全书的核心在于展示“信念的更新”过程,从先验概率的选择到后验分布的构建,每一步都充满了逻辑上的严密性和直观上的合理性。书中对共轭先验、Priors的选择困难,以及如何通过实际数据不断修正我们对世界认知的探讨,极为深刻。更具操作性的是,作者并没有仅仅停留在理论层面,而是详细讲解了如何使用Gibbs采样、Metropolis-Hastings算法等现代计算工具来解决高维积分问题。这些计算方法的介绍非常详尽,代码示例清晰,使得复杂的贝叶斯模型不再是纸上谈兵。对于那些厌倦了“P值陷阱”并渴望更具解释力的统计推断方法的从业者或学者来说,这本书无疑是一剂良方,它教会我们如何更负责任地处理不确定性。

评分☆☆☆☆☆

是一本非常好的书

评分☆☆☆☆☆

是一本非常好的书

评分☆☆☆☆☆

下册都是应用,有一些有意思的东西比如Kalman-Bucy filter和separation principle,挺有意思但是我还是觉得在continuous time下面做separation principle从实践角度来看就是扯淡。

评分☆☆☆☆☆

下册都是应用,有一些有意思的东西比如Kalman-Bucy filter和separation principle,挺有意思但是我还是觉得在continuous time下面做separation principle从实践角度来看就是扯淡。

评分☆☆☆☆☆

是一本非常好的书