
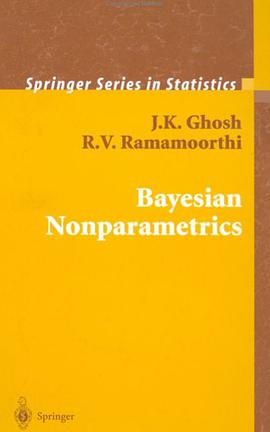
Bayesian Nonparametrics pdf epub mobi txt 电子书 下载 2026
- 数学
- 贝叶斯
- 统计学
- 统计
- 机器学习
- Springer
- 贝叶斯非参数统计
- 贝叶斯方法
- 统计学
- 机器学习
- 概率模型
- Dirichlet过程
- 先验分布
- 模型选择
- 统计推断
- 随机过程

具体描述
This book is the first systematic treatment of Bayesian nonparametric methods and the theory behind them. It will also appeal to statisticians in general. The book is primarily aimed at graduate students and can be used as the text for a graduate course in Bayesian non-parametrics.
作者简介
目录信息
读后感
用户评价
从阅读的难度和所需的前置知识来看,我必须承认,这本书的门槛确实不低,它绝不是一本可以“快速入门”的读物。作者对读者已经掌握的概率论和线性代数基础知识抱有很高的期望,很多推导过程被刻意省略了,假定读者可以自行完成那些基础的代数运算。在我尝试深入研读其中关于随机过程建模的章节时,我不得不频繁地暂停,查阅一些更基础的测度论概念。这表明,本书更侧重于对高级理论的深入探讨和前沿研究方法的介绍,而不是面向零基础的初学者。但对于那些已经有一定基础,希望将自己的知识体系提升到可以应对复杂实际问题的研究人员或博士生来说,这本书无疑是一座宝库。它迫使你走出舒适区,去直面那些最严峻的理论挑战,并提供了一条清晰的路径,指导你如何用严谨的数学语言来描述和解决现实世界的模糊性。
评分全书的收尾部分尤其令人印象深刻。在最后几章,作者将前文介绍的所有工具和理论融会贯通,开始探讨一些当前统计学界仍在激烈争论的前沿课题。他没有给出绝对的“标准答案”,而是非常公正地呈现了不同学派在处理特定难题时的优劣势。这种开放式的收尾方式,极大地激发了我的批判性思维和探索欲,让我觉得这本书读完之后,知识的探索并未终结,反而是一个新的起点。我感受到了作者希望读者能够继承并发展这些理论的殷切期望。此外,书末的参考文献列表的广度和深度也令人惊叹,它不仅仅是一份简单的引用清单,更像是一份详尽的、经过高度筛选的研究导览图,指明了未来深入研究的各个方向。总而言之,这是一部集大成之作,它不仅教会了“如何做”,更重要的是教会了“为何要如此思考”,其价值远远超出了其作为一本统计学专著的范畴。
评分这本书的封面设计简直是一场视觉盛宴,那种深邃的蓝色调配合着烫金的标题字体,立刻就给人一种高端、严谨的学术氛围。拿到手里沉甸甸的感觉,让人不禁对手册中蕴含的知识深度产生了极高的期待。装帧质量无可挑剔,纸张的触感细腻而有质感,即便是长时间阅读也不会感到疲惫。书脊的装订也相当牢固,预示着这是一本可以陪伴我度过漫长学习旅程的良伴。我尤其欣赏作者在排版上下的功夫,清晰的章节划分、恰到好处的留白,使得那些复杂的公式和推导过程在视觉上得到了极大的舒缓,不会让人一眼望去就心生畏惧。对于初次接触这个领域的人来说,这种友好的界面设计无疑是降低了入门门槛的第一步。翻开扉页,扉页上的那段引言,虽然内容我暂时无法完全理解,但其蕴含的哲学思辨气息,已经让我对即将展开的阅读之旅充满了敬畏和好奇。整体而言,这本书在实体呈现上,已经超越了一本普通教科书的范畴,更像是一件精心雕琢的艺术品,体现了出版方对知识载体的尊重。
评分我花了整整一个下午的时间,才勉强浏览完前三章的绪论部分,最大的感受是,作者在构建知识体系上的逻辑性简直达到了炉火纯青的地步。他没有急于抛出那些令人望而生畏的数学符号,而是先从历史的演进和核心思想的起源娓娓道来,用大量生动的类比和实际的应用场景来铺陈概念的基础。比如,在介绍参数估计的背景时,作者穿插引用了许多十九世纪统计学家的书信往来片段,这种“讲故事”的方式极大地激发了我的求知欲,让我感觉自己不是在啃一本枯燥的教材,而是在跟随一位博学的导师进行一场穿越时空的对话。每一个新的概念,作者都会用至少两种不同的角度去阐释,确保读者能够从直观的几何图像理解到严谨的代数推导之间的桥梁得以建立。这种细致入微的教学安排,使得原本那些抽象的统计学原理,仿佛被赋予了鲜活的生命力,在我脑海中构建出了清晰的认知框架。可以说,阅读体验是一种渐进式的、层层深入的享受,每一次翻页都像是揭开了一个新的谜团。
评分这本书的章节间的衔接处理得极为巧妙,几乎感觉不到生硬的转折。特别是当涉及到一些需要跨领域知识才能理解的概念时,作者总能非常优雅地引入必要的背景信息,而不会让人产生“跑题”的感觉。我注意到,在讨论模型的选择与复杂度控制的部分,作者花了大量篇幅来探讨“奥卡姆剃刀”原理在现代统计推断中的具体操作含义,并将其与信息论中的某些度量标准巧妙地关联起来。这种宏观的视野和微观的细节兼顾的能力,展现了作者深厚的学术功底。而且,书中大量的图表绘制质量非常高,那些概率密度函数的图形,线条流畅、颜色区分得当,即便是多变量分布的投影图,也能做到一目了然,极大地辅助了对高维空间直觉的培养。我甚至将其中几张关于贝叶斯推断迭代过程的流程图打印出来贴在了我的工作区,作为日常的参考和提醒。这种实用性与美观性并存的插图设计,是许多同类书籍所无法比拟的。
评分 评分 评分 评分 评分相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有