
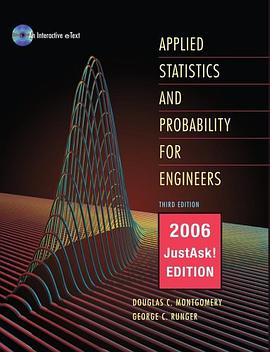
Applied Statistics and Probability for Engineers 2006 pdf epub mobi txt 电子书 下载 2026
- 统计学
- 概率论
- 工程应用
- 应用统计
- 概率模型
- 数据分析
- 工程师
- 统计推断
- 随机过程
- 可靠性工程

具体描述
This title features the following items. More Motivation - in this title, a completely revised chapter 1 gets students motivated right from the beginning. Revised Probability Topics - the authors have revised and enhanced probability topics to promote even easier understanding. Chapter Reorganization - chapters on hypothesis testing and confidence intervals have been reorganized and rewritten. There is now expanded treatment of confidence intervals, prediction intervals, and tolerance intervals.Real Engineering Applications - treatment of all topics is oriented towards real engineering applications. In the probability chapters, the authors do not emphasize counting methods or artificial applications such as gambling. Real Data, Real Engineering Situations - examples and exercises throughout text use real data and real engineering situations. This motivates students to learn new concepts and gives them a taste of practical engineering experience. Use of the Computer - computer usage is closely integrated into the text and homework exercises.
作者简介
目录信息
读后感
用户评价
这本书最让我欣赏的一点,是它对实验设计(Design of Experiments, DOE)原理的强调和系统性介绍。在工程领域,我们经常需要通过受控实验来优化流程或产品性能,而这本书提供了一个非常坚实的方法论基础。从最基础的单因子完全随机化设计(CRD),到更复杂的随机区组设计(RBD),再到析因设计(Factorial Designs),作者的叙述逻辑清晰,层层递进,确保读者能够理解每个设计背后的统计效率和适用场景。特别是对于交互作用的分析,书中通过方差分析(ANOVA)的表格来展示如何量化不同因素组合带来的非加性效应,这在产品优化中是发现关键创新点的重要工具。这本书成功地将统计推断的严谨性与工程优化的实用性完美结合起来。然而,如果非要鸡蛋里挑骨头,那就是它对非参数统计方法的覆盖略显单薄。在处理那些明显不符合正态分布假设、或者样本量极小、数据类型为有序或名义变量的情况时,书中提供的工具箱显得有点局限,多数情况下还是倾向于依赖参数检验方法,这使得这本书在应对一些非标准化的、探索性的工程研究时,其普适性会受到一定的限制。
评分这本书的排版和印刷质量是无可挑剔的,纸张的质感很好,长时间阅读眼睛也不会太累,这对于一本需要反复查阅的参考书来说,是极其重要的加分项。在统计推断的章节,作者采取了一种非常审慎的态度,强调了样本代表性和数据收集的规范性,这在充斥着“大数据”概念的今天,显得尤为珍贵。他们用相当大的篇幅讨论了如何识别和处理异常值(Outliers),以及如何判断数据是否符合特定分布的检验方法(如Shapiro-Wilk检验),这些都是实践中极其容易被初学者忽略却又至关重要的环节。书中对于置信区间的几何意义解释得非常直观,配图清晰地展示了随着样本量的增加,区间如何收敛到真实参数附近,这种视觉化的教学方法极大地增强了读者的直觉理解。唯一让我感到有些头疼的是,书中的习题部分,虽然数量很多,但对于奇数题目的答案只给出了最终结果,而没有提供详细的解题步骤。对于那些需要通过模仿解题步骤来学习的读者,比如我这样需要反复验证自己思路是否正确的学习者来说,这无疑增加了学习的难度和时间成本,常常需要翻阅在线论坛去寻找其他学习者分享的解题思路。
评分这本书的篇幅适中,不像某些动辄上千页的“百科全书”那样让人望而生畏,它更像一位耐心且知识渊博的导师,知道在什么时候应该深入,什么时候应该点到为止。我尤其欣赏作者在讲解假设检验部分时所采用的逻辑框架。他们没有急于抛出Z检验、T检验这些具体工具,而是花费了大量的篇幅来阐述“原假设”与“备择假设”背后的哲学思想,以及I类错误和II类错误的权衡,这对于培养工程师的批判性思维至关重要。在阅读过程中,我发现书中很多例题的设置都非常贴近实际生产环境,比如如何根据一批次材料的检测数据来判断供应商是否达标,或者如何设计一个实验来确定不同生产工艺对产品性能的影响程度。这些例题的详细解答步骤,对于自学者来说简直是福音,每一个计算过程都写得清清楚楚,很少出现需要读者自行脑补的跳跃。美中不足的是,对于高阶的多元统计分析,比如主成分分析(PCA)或因子分析,本书只是简单地提及了概念,并没有深入展开讲解它们在工程降维或特征提取中的实际威力,这让那些想要更进一步探索复杂数据模型的读者会感到意犹未尽,需要另寻高明的资料来补充这块知识盲区。
评分这本书的封面设计着实吸引人,那种沉稳的蓝色调,配上清晰的字体,让人一眼就能感受到这是一本严谨的教材。我抱着极高的期望翻开了第一页,主要想看看它如何将那些抽象的统计学概念与实际的工程问题结合起来。书中对于基础概率论的阐述相当扎实,从排列组合到各种概率分布,讲解得循序渐进,对于初次接触这门学科的读者来说,提供了非常友好的入门路径。特别是它引入了一些经典的工程案例,比如质量控制中的抽样检验,或是可靠性工程中的寿命分析,这些例子使得原本枯燥的公式有了鲜活的背景。我记得有一章专门讲了中心极限定理的应用,作者用图示和逐步推导的方式,把这个“统计学皇冠上的宝石”讲得透彻明白,让我这个过去总是在公式上打滑的人,第一次感觉抓住了问题的核心。不过,要说缺点,初版的内容在软件应用这一块显得稍稍有些滞后了,虽然提到了SPSS和Minitab的一些操作,但对于后来兴起的R语言或Python在数据分析中的应用则完全没有涉及,这对于今天的工程师来说,无疑是一个遗憾。总体而言,作为一本奠定理论基础的参考书,它无疑是称职的,只是在与时俱进的步伐上,略显迟缓了。
评分说实话,我购买这本书的初衷是为了解决工作中的随机过程问题,毕竟工程领域充满了时间序列和随机现象。我对书中关于随机过程的章节寄予了厚望,希望它能提供一个清晰的路线图来理解马尔可夫链和泊松过程在排队论中的应用。看完这部分内容后,我的感受是复杂且矛盾的。从理论深度上来说,它确实覆盖了随机过程的基石,对于理解随机变量的演变过程有很大帮助。作者对随机变量的矩描述和矩母函数的运用讲解得非常到位,这在处理系统稳态分析时特别有用。然而,在实际应用案例的广度和新颖性上,这本书显得有些保守了。它更多地聚焦于传统的电话交换系统或交通流模型,对于现代信息工程中常见的网络拥塞模型、信号处理中的噪声分析等前沿应用几乎没有涉及。这就导致,尽管我理解了理论框架,但在尝试将这些工具应用到我正在研究的物联网传感器数据分析时,总觉得缺少了那么一层“桥梁”。这本书更像是为传统的机械、土木或基础电子工程背景的读者量身定做,对于信息科学或计算机工程背景的从业者来说,可能需要自己去“翻译”和“升级”这些经典模型。
评分 评分 评分 评分 评分相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有