
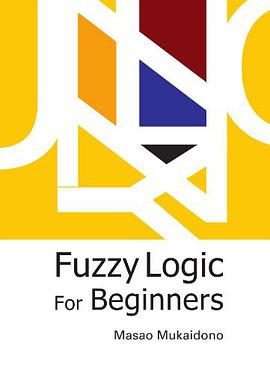

具体描述
There are many uncertainties in the real world. Fuzzy theory treats a kind of uncertainty called fuzziness, where it shows that the boundary of yes or no is ambiguous and appears in the meaning of words or is included in the subjunctives or recognition of human beings. Fuzzy theory is essential and is applicable to many systems - from consumer products like washing machines or refrigerators to big systems like trains or subways. Recently, fuzzy theory has been a strong tool for combining new theories (called soft computing) such as genetic algorithms or neural networks to get knowledge from real data. This introductory book enables the reader to understand easily what fuzziness is and how one can apply fuzzy theory to real problems - which explains why it was a best-seller in Japan.
作者简介
目录信息
读后感
用户评价
这本书的价值,在于它成功地架设了一座跨学科交流的桥梁。我发现,很多传统上被认为只属于信息科学领域的概念,在这里被巧妙地融入了认知科学和决策理论的框架之中。作者并没有将模糊逻辑视为一个孤立的数学工具,而是将其置于人类认知不确定性处理的大背景下去考察。特别是在探讨模糊决策树的构建时,作者引入了决策心理学中的“启发式”偏差概念,解释了为什么在某些情况下,一个“听起来合理”的模糊规则比一个精确计算的结果更能被接受。这种跨学科的视角,对于我这种背景相对复杂的研究者来说,提供了全新的分析工具和思考角度。全书的论证结构严谨有力,但行文却保持了一种开放的姿态,不强行灌输任何单一的观点。它鼓励读者去质疑和探索,书中的每一个结论都像是向读者发出的邀请函,邀请我们去检验和扩展这些概念的边界。读完之后,我感觉自己对“精确”的定义都有了一种全新的、更加辩证的认识。
评分阅读体验的流畅性,很大程度上取决于作者的“叙事”能力,而这本书在这方面简直是大师级的表现。作者的语言风格是那种非常沉稳且富有启发性的,不像有些技术书籍那样干巴巴的,充满了术语的堆砌。相反,他们像一位经验丰富的导师,总能在关键的转折点插入一段“思考题”或者“历史背景介绍”,让理论的学习不再是孤立的知识点吸收,而变成了一段探索知识演变过程的旅程。例如,在介绍模糊集的创始人Zadeh的早期工作时,作者描绘了当时控制论界面临的困境,使得模糊逻辑的诞生显得如此顺理成章且充满必然性。此外,本书在术语的引入上处理得极其克制和审慎。每一个新的专业词汇,比如“反模糊化”或“专家系统”,都会先用白话文进行充分的解释和铺垫,确保读者能够完全理解其内涵后,才正式引入符号表示。这种对读者心理和学习曲线的深度洞察,使得我在阅读过程中几乎没有产生“跳读”或“跳过难点”的冲动,因为即便是最复杂的部分,也被分解成了易于消化的模块。
评分这本书的排版和装帧简直让人眼前一亮,那种沉稳又不失现代感的封面设计,拿在手里就感觉自己仿佛已经踏入了某种严谨而又充满魅力的学术殿堂。内页的纸张选择也十分考究,阅读时几乎没有反光带来的视觉疲劳,即便是长时间盯着复杂的图表和公式看,眼睛也感觉很舒适。不过,更让我惊喜的是作者对于概念的阐述方式。他们似乎深谙“新手”的思维盲区,从最基础的集合论概念引入,娓娓道来,不急不躁。特别是对“隶属度函数”的引入,作者没有直接抛出那些晦涩的数学定义,而是通过生活中的例子,比如“有点热”和“非常热”之间的模糊边界,让读者在潜移默化中建立起直观的认识。这种教学上的细腻处理,使得原本被认为高高在上的模糊逻辑,一下子变得亲切可感。章节之间的逻辑过渡也处理得极为自然,前一章的知识点像是为下一章的深入打下了坚实的地基,很少出现那种“此处需要先学别的知识”的断裂感。可以说,从物理接触到知识吸收的整个过程,这本书都展现出了一种对读者体验的极致关怀。那种对细节的执着,让我对后续内容的学习充满了信心和期待。
评分我花了一整个周末的时间,沉浸在这本书的章节中,最大的感受是作者在案例选择上的独到眼光。他们没有陷入那种教科书式的、过度简化的虚拟场景,而是选取了许多贴近工业控制和日常决策的实际问题。比如,在讲解模糊推理系统(Fuzzy Inference System, FIS)的构建时,作者详细剖析了一个关于空调温度调节的案例,从环境温度的采集、到模糊规则库的建立,再到最终的清晰化输出,每一步都配有详细的流程图和伪代码级别的解释。这种写法的优势在于,它不仅仅是在“教”你理论,更是在“教”你如何“思考”和“应用”这个理论。我特别喜欢其中一个关于风险评估的章节,作者巧妙地将概率论中的不确定性与模糊逻辑中的不精确性做了对比分析,帮助我清晰地区分了两种处理不确定性的哲学立场。这种比较分析,极大地拓宽了我对“不确定性建模”这个大主题的理解深度。书中很多图示并非简单的示意图,而是经过精心设计的,能够直观地展示决策面的变化,这比单纯依靠文字描述要高效得多。对于希望将模糊逻辑应用于实际工程项目的读者来说,这本书提供的“实战蓝图”价值连城。
评分对于任何技术书籍而言,配套资源的质量往往决定了学习的上限,而这本书在这方面展现出了极高的专业水准。虽然我手头只有纸质版,但我能感受到作者在构建知识体系时所考虑的广度和深度。书中每章末尾的“延伸阅读”部分并非敷衍了事,而是针对性地推荐了该领域最具影响力的几篇经典论文,并附上了简短的摘要,清晰地指明了这些文献对本章内容的补充作用,是继续深挖的绝佳入口。更值得称赞的是,作者在某些算法的描述中,穿插了对不同实现效率的讨论。比如,在比较几种不同的模糊推理引擎时,书中不仅展示了它们在逻辑上的等价性,还分析了在不同规模数据集下的计算复杂度差异,这对于未来的软件架构设计者来说是至关重要的信息。这种将理论与工程实践(特别是性能考量)相结合的视角,让这本书的实用价值远远超出了纯粹的理论教材范畴。它提供的不仅仅是“是什么”,更是“为什么用这种方法”和“如何用更优化的方式实现”。
评分日本人写的超级入门的模糊逻辑书,讲得很生动,英语很容易懂。不过稍微有一点儿too naive了,不过还好,推荐本科低年级看。
评分日本人写的超级入门的模糊逻辑书,讲得很生动,英语很容易懂。不过稍微有一点儿too naive了,不过还好,推荐本科低年级看。
评分日本人写的超级入门的模糊逻辑书,讲得很生动,英语很容易懂。不过稍微有一点儿too naive了,不过还好,推荐本科低年级看。
评分日本人写的超级入门的模糊逻辑书,讲得很生动,英语很容易懂。不过稍微有一点儿too naive了,不过还好,推荐本科低年级看。
评分日本人写的超级入门的模糊逻辑书,讲得很生动,英语很容易懂。不过稍微有一点儿too naive了,不过还好,推荐本科低年级看。
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有