
Applied Logistic Regression Analysis pdf epub mobi txt 电子书 下载 2026
- Logistic Regression
- Statistics
- Data Analysis
- Modeling
- Machine Learning
- Biostatistics
- Epidemiology
- Regression Analysis
- Applied Statistics
- Healthcare

具体描述
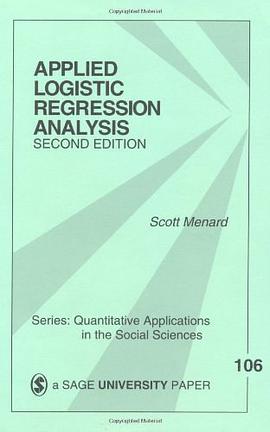
The focus in this Second Edition is on logistic regression models for individual level (but aggregate or grouped) data. Multiple cases for each possible combination of values of the predictors are considered in detail and examples using SAS and SPSS included. New to this edition: * More detailed consideration of grouped as opposed to casewise data throughout the book * Updated discussion of the properties and appropriate use of goodness of fit measures, R2 analogues, and indices of predictive efficiency * Discussion of the misuse of odds ratios to represent risk ratios, and of overdispersion and underdispersion for grouped data * Updated coverage of unordered and ordered polytomous logistic regression models.
作者简介
目录信息
读后感
用户评价
这本书的实操指导部分,虽然不像一些纯粹的软件手册那样提供详尽的截图和点击步骤,但其提供的方法论指导却显得更为高瞻远瞩。作者更侧重于“什么时候”以及“为什么”应该使用某种方法,而非仅仅是“怎么做”。例如,在探讨样本量要求时,书中引用了几项关于事件发生率和预测变量数量的经验法则,并用模拟的例子展示了当事件发生率过低时,模型估计的不稳定性。这让我意识到,很多时候我们过于依赖软件跑出来的结果,而忽略了数据本身的固有属性对模型可靠性的制约。此外,书中关于模型可解释性与预测精度的权衡讨论,也让我受益匪浅。它提醒我,一个在AUC上略逊一筹但结构清晰、易于解释的模型,在商业决策场景中往往比一个“黑箱”模型更有价值。这种成熟的视角,体现了作者深厚的行业经验。
评分这本《应用逻辑回归分析》的封面设计得极为朴实,甚至可以说有些枯燥,这让我一开始对接下来的阅读内容抱有一丝警惕。然而,一旦深入到前几章,我发现作者在理论阐述上的严谨性是毋庸置疑的。书中对于逻辑回归模型背后的统计学原理,尤其是广义线性模型(GLM)的框架,进行了非常细致的铺陈。它并没有止步于提供一堆现成的公式,而是着重解释了为什么我们要选择Logit链接函数,以及最大似然估计(MLE)是如何在非正态分布的因变量情况下发挥作用的。对于那些希望真正理解“黑箱”背后机制的读者来说,这部分内容无疑是金矿。我尤其欣赏作者在引入变量选择和多重共线性处理时所展现的耐心;他没有急于展示复杂的代码输出,而是先用直观的例子说明了模型设定不当可能带来的偏差,这种注重基础和理解深度的教学方式,让我在后续进行更复杂的模型构建时,心里有底气。那种感觉就像是,你不仅学会了怎么用计算器,更明白了乘法和除法背后的逻辑,而不是死记硬背的步骤。
评分从整体的阅读体验来看,这本书的价值在于它成功地架起了一座桥梁,连接了教科书式的统计理论和实际业务场景中复杂、不完美的数据。它的语言风格是高度学术化的,论证逻辑严密,几乎没有冗余的叙述,这对于追求效率的专业人士来说是极大的优势。我尤其赞赏作者在最后几章对模型验证策略的讨论,包括交叉验证(Cross-Validation)在逻辑回归中的应用,以及如何避免在测试集上过度优化导致的结果虚高。它强迫我从一个纯粹的“拟合模型”的心态,转变为一个“建立可靠、可推广的预测系统”的思维模式。读完此书,我感觉自己对“选择最佳模型”这件事的理解层次得到了质的飞跃,不再满足于仅仅报告一个高的准确率数字,而是开始关注模型的稳定性和对未来未知数据的泛化能力。这绝对是一本值得反复研读的深度参考书。
评分阅读这本书的过程,简直像是在进行一场高强度的智力马拉松,尤其是那些关于模型诊断和结果解释的部分。我感觉自己像是一个刚刚接触侦探工作的菜鸟,手里拿着所有线索,却不知道如何拼凑出完整的案情。作者在处理模型拟合优度(Goodness-of-Fit)时,详细对比了Deviance统计量、Hosmer-Lemeshow检验以及各种$R^2$的局限性,这远超出了我之前在其他教材中看到的泛泛而谈。最让我印象深刻的是关于残差分析的章节,它不仅仅停留于检查异常值,更是深入探讨了在逻辑回归中如何解读标准化残差和残差的趋势图,以识别过拟合或欠拟合的风险。每当我感觉自己快要被那些复杂的统计术语淹没时,作者总能巧妙地穿插一个现实世界中的案例——比如预测客户流失率或是疾病发生的可能性——来拉我一把,让我重新聚焦于“应用”二字上。这种理论深度与实践落地的紧密结合,使得这本书在我手中不仅仅是一本工具书,更像是一本高级的统计思维训练手册。
评分如果说这本书有什么让人感到略微吃力的地方,那可能就在于它对复杂效应处理的深入挖掘上。作者非常坦诚地讨论了交互项的解释难题,以及如何通过添加非线性项(如多项式项)来捕捉曲线关系,这在很多入门级的回归分析书籍中往往被简化或直接跳过了。在处理分类变量的编码问题时,书中详细对比了哑变量陷阱(Dummy Variable Trap)和效应编码(Effect Coding)在解释系数上的细微差别,这对于需要撰写严谨学术报告的人来说,是至关重要的细节。我花了相当长的时间来消化这部分内容,因为它要求我不仅要会运行软件,还要能准确地向非统计学背景的同事解释“基准组”和“参考类”对预测概率的具体影响。总而言之,这本书毫不留情地将读者推向了高阶分析的门槛,它不提供捷径,而是要求你扎实地掌握每一个决策背后的统计学依据,这无疑提高了阅读门槛,但同时也极大地提升了读者的分析能力。
评分论文要用的 是的,没看懂,最后又在网上搜了PPT个论文才搞懂的这个模型
评分论文要用的 是的,没看懂,最后又在网上搜了PPT个论文才搞懂的这个模型
评分论文要用的 是的,没看懂,最后又在网上搜了PPT个论文才搞懂的这个模型
评分论文要用的 是的,没看懂,最后又在网上搜了PPT个论文才搞懂的这个模型
评分论文要用的 是的,没看懂,最后又在网上搜了PPT个论文才搞懂的这个模型
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有