
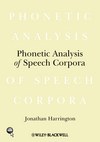
Phonetic Analysis of Speech Corpora pdf epub mobi txt 电子书 下载 2026
- 语料库
- 语音学
- 数据处理
- 语音研究
- 语音
- programming
- R
- Phonetics
- 语音学
- 语音分析
- 语音语料库
- 音系学
- 语音识别
- 信号处理
- 实验语音学
- 计算语言学
- 语音技术
- 语音数据库

具体描述
The Phonetic Analysis of Speech Corpora introduces methods of analyzing phonetically-labelled speech corpora, with the goal of testing hypotheses that often arise in experimental phonetics and laboratory phonology. Each chapter has an extensive set of exercises, with answers to reinforce the techniques introduced. Clearly laid out, with easy-to-follow computer commands, spectrograms of speech corpora, and a companion website with more illustrations and downloadable speech corpora for testing purposes, this book is a complete resource for the research increasingly conducted in phonetics.
Contents
Preface.
Notes on Downloading Software.
1. Using Speech Corpora in Phonetics Research
2. Some Tools for Building and Querying Annotated Speech Databases
3. Applying Routines for Speech Signal Processing
4. Querying Annotation Structures
5. An Introduction to Speech Data Analysis in R: A Study of an EMA Database
6. Analysis of Formants and Formant Transitions
7. Electropalatography
8. Spectral Analysis
9. Classification
References
Index
作者简介
目录信息
读后感
新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自己的数据上做了几次formant tracking,男的还行,女的错误太多了。但是用作者自己的数据练练还行。 新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自...
评分新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自己的数据上做了几次formant tracking,男的还行,女的错误太多了。但是用作者自己的数据练练还行。 新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自...
评分新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自己的数据上做了几次formant tracking,男的还行,女的错误太多了。但是用作者自己的数据练练还行。 新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自...
评分新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自己的数据上做了几次formant tracking,男的还行,女的错误太多了。但是用作者自己的数据练练还行。 新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自...
评分新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自己的数据上做了几次formant tracking,男的还行,女的错误太多了。但是用作者自己的数据练练还行。 新版本到现在还在开发阶段,而且很多bug,帮助论文里回馈也很慢,想法是很好的。 在自...
用户评价
从内容结构上看,这本书的章节划分似乎是按照工程实施的步骤来组织的,缺乏一种流畅的逻辑递进感。例如,数据存储与检索的章节被放置在对语谱分析方法的介绍之前,这使得读者在没有理解分析目标的情况下,就先被灌输了一堆关于数据库优化和文件格式兼容性的知识。这种“技术先行”的组织方式,极大地阻碍了对核心分析理念的吸收。我尝试寻找一些关于跨语言语音语料库构建的比较研究,看看不同语言体系(如声调语言与非声调语言)在数据采集和特征提取上的根本差异,但这方面的内容几乎没有。它更像是一份针对单一、预设语言环境的“最佳实践”指南,对于那些研究领域更广阔、需要处理非标准或低资源语言数据的研究者来说,其普适性大打折扣。如果作者能将理论框架置于前,将工程实现作为应用支撑,阅读体验可能会有天壤之别。
评分总而言之,这本书给我的感觉是,它似乎是为一群已经非常成熟的、拥有完备软硬件基础设施的大型实验室编写的内部参考手册,而非面向更广泛的研究群体或学生的教材。它假设了读者对现有主流语音处理软件和平台已经了如指掌,因此在介绍新方法时,极少使用图示或操作步骤来辅助理解。我期待看到更多关于新兴语音技术如何反哺语料库构建的讨论,比如利用深度学习模型对噪声信号的预处理能力,或者如何利用众包平台来提高标注效率和一致性。这些前沿的、交叉学科的动态在本书中几乎找不到踪影。它更像是一个对现有范式进行精细打磨的工具书,而非引领未来方向的创新之作。对于希望在语音分析领域开辟新思路的读者来说,这本书提供的视角可能略显陈旧和局限。
评分这本书,坦率地说,我原本是带着极高的期望去翻阅的,毕竟它的名字听起来就指向了语音学研究的深水区。然而,翻过前几页后,我发现这本书更像是一份详尽的、近乎枯燥的工具手册,而不是我所期待的那种富有洞察力的分析导论。它花费了大量的篇幅去介绍如何构建一个“理想的”语音语料库,从麦克风的拾音特性到样本采集环境的声学标准,都有着近乎教条式的描述。这些技术细节固然重要,但对于一个希望了解“语音分析”核心思想的读者来说,显得过于前置和冗余。我更希望看到的是,作者如何巧妙地处理现实世界中语料库的缺陷,例如不同说话人之间的音质差异、环境噪声的过滤策略,以及如何通过创新的算法来平衡数据的规模与质量。书中对这些实践中的“灰色地带”着墨不多,仿佛在暗示存在一个完美无瑕的采集流程,这与我在实际工作中遇到的种种挑战大相径庭。整体而言,它更适合作为一名严格的项目经理的案头参考书,而不是一个想要深入理解语音现象本质的研究者的首选读物。那种对语音学理论如何映射到实际数据处理流程的精彩论述,在本期待中显得尤为匮乏。
评分这本书的排版和行文风格,让我时常有种在阅读一份上世纪八十年代的技术规范文档的错觉。语言极其凝练,甚至到了晦涩的程度,充满了各种缩写和行业术语,如果没有一个非常扎实的语音学背景,初次接触很容易被其密度压垮。我尝试去寻找一些关于语料库应用案例的深入剖析,比如特定方言的韵律变化是如何被捕捉和量化的,或者在机器翻译模型训练中,不同类型语料库的鲁棒性对比分析。然而,这些期待中的“实战”内容被大量篇幅的数学公式和统计模型推导所取代。虽然我理解严谨的科学论证需要数学支撑,但这些推导过程往往缺乏足够的上下文解释,使得读者很难领会这些模型背后的直觉意义。读到一半,我开始感觉自己像是在学习一门全新的、高度抽象的编程语言的语法,而不是在探索一个充满活力的、与人类交流紧密相关的研究领域。它似乎过分强调了“如何做”的机械流程,而忽略了“为什么这样做”背后的认知科学动机。
评分最让我感到困惑的是,这本书在处理“语音变异性”这一核心问题时显得力不从心。语音学研究的魅力恰恰在于人类语言的无限多样性,口音、语速、情绪状态都会对声学信号产生剧烈影响。我期望这本书能提供一套系统的方法论,来系统性地比较和对比不同特征(如年龄、性别、地域)对音位和音位超段特征的系统性偏移。然而,这本书似乎将重点放在了如何标准化和“清洗”数据,以达到某种理想化的、去背景化的声学目标。这种过度追求“纯净”数据的倾向,反而削弱了语料库在模拟真实世界交流场景中的价值。当它终于触及到语料库标注的复杂性时,描述也显得非常表面化,比如仅仅提到了音位边界的标注难度,却未能深入探讨诸如情感标签、说话意图等高层语义信息在自动捕获和人工验证中的内在矛盾和权衡。可以说,这本书提供了一个理想化的蓝图,但在描绘通往这个蓝图的崎岖小路时,却显得笔触犹豫和苍白。
评分还得再读一遍,论文里用上
评分还得再读一遍,论文里用上
评分还得再读一遍,论文里用上
评分还得再读一遍,论文里用上
评分还得再读一遍,论文里用上
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有