
Analyzing Microarray Gene Expression Data pdf epub mobi txt 电子书 下载 2026
- 基因表达谱分析
- 微阵列
- 生物信息学
- 数据分析
- 统计学
- 基因组学
- 生物医学
- 机器学习
- R语言
- 生物信息学工具

具体描述
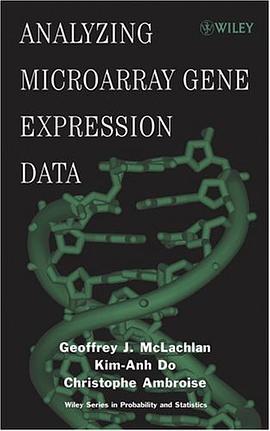
A multi-discipline, hands-on guide to microarray analysis of biological processes Analyzing Microarray Gene Expression Data provides a comprehensive review of available methodologies for the analysis of data derived from the latest DNA microarray technologies. Designed for biostatisticians entering the field of microarray analysis as well as biologists seeking to more effectively analyze their own experimental data, the text features a unique interdisciplinary approach and a combined academic and practical perspective that offers readers the most complete and applied coverage of the subject matter to date. Following a basic overview of the biological and technical principles behind microarray experimentation, the text provides a look at some of the most effective tools and procedures for achieving optimum reliability and reproducibility of research results, including:* An in-depth account of the detection of genes that are differentially expressed across a number of classes of tissues* Extensive coverage of both cluster analysis and discriminant analysis of microarray data and the growing applications of both methodologies* A model-based approach to cluster analysis, with emphasis on the use of the EMMIX-GENE procedure for the clustering of tissue samples* The latest data cleaning and normalization procedures* The uses of microarray expression data for providing important prognostic information on the outcome of disease
作者简介
目录信息
读后感
用户评价
这本书的封面设计给我留下了极其深刻的印象,那种深邃的蓝色调配上简洁的白色字体,立刻营造出一种专业且严谨的学术氛围。我本来对生物信息学和高通量数据分析领域的新书抱持着一种审慎的态度,毕竟市面上充斥着太多内容陈旧或者讲解过于浅显的教材。然而,当我翻开这本书的扉页时,那种排版上的考究和逻辑上的清晰感,让我立刻意识到这不是一本随便拼凑出来的作品。它在组织章节结构时展现出一种非凡的洞察力,似乎作者不仅精通数据处理的底层逻辑,更懂得如何将复杂的概念层层剥茧,以最有效的方式植入读者的认知框架中。特别是前几章对基础统计学概念的回顾与数据预处理流程的介绍,处理得既不拖沓也不跳跃,恰到好处地为后续深入分析搭建了坚实的桥梁。即便是对这方面略有涉猎的研究生,也能从中找到提升效率和准确性的新思路。这种对细节的打磨,体现在图表的清晰度、公式的准确性以及术语定义的精确性上,无不体现出编撰者对学术严谨性的执着追求。那种扎实的学术功底,让人愿意沉下心去逐字逐句地研读,而不是走马观花。
评分这本书的语言表达能力简直是教科书级别的——流畅、精确、且极富逻辑性。我发现自己很少需要频繁地查阅词典或反复阅读同一段落以理解其深层含义。作者在构建复杂的论证链条时,总能找到最简洁也最准确的词汇来表达科学思想。特别是对于那些涉及到概率论和矩阵运算的章节,作者的解释策略非常巧妙,往往先用一个生动的类比来建立直观理解,然后再引入严谨的数学表述,这种“先易后难”的教学设计极大地降低了学习曲线的陡峭程度。我注意到,全书的行文节奏把握得非常到位,没有出现信息密度过高导致的阅读疲劳。每完成一个主要模块的学习,作者都会用一个简短的“总结与展望”来帮助我们巩固知识点,这种结构上的仪式感,让知识点的吸收和内化过程变得更加系统和完整。总而言之,它不仅仅是知识的载体,更是一次愉悦的智力体验。
评分这本书的叙述风格,对我这个更偏向实验生物学背景的研究人员来说,简直是一股清流。它没有陷入那种晦涩难懂的数学推导的泥潭,而是将重点放在了“为什么”和“如何应用”上。我尤其欣赏作者在阐述不同分析方法的章节中,总是会穿插一些实际的案例研究或者“陷阱”警示。这使得原本抽象的算法描述变得具体可感,仿佛身边有一位经验丰富的导师在手把手指导。比如,它对批次效应(Batch Effect)处理方法的对比分析,就做得极其透彻,不仅仅是罗列了各种矫正模型的优缺点,更重要的是,它结合不同的实验设计情境,给出了实际操作中的建议权重。这种务实的态度,让这本书超越了一般的教科书范畴,更像是一本高级实战手册。读完相关章节后,我立刻尝试将书中的方法论应用到我手头的几组旧数据上,惊喜地发现原先那些难以解释的噪音点,通过新的处理流程得到了有效的优化和解释。这种立竿见影的反馈,极大地增强了我的学习动力,也验证了其内容的实用价值。
评分如果非要挑剔这本书的某些方面,我可能会认为它在面向完全初学者的友好度上,似乎略显“高阶”。虽然我个人非常享受这种高强度的信息输入,但对于一个刚刚接触数据分析的本科生来说,可能需要配合额外的基础编程课程才能完全跟上节奏。书中假设读者已经对R语言或Python中的基本数据结构和函数操作有了一定的熟悉度,对于这些基础的“如何编程”部分着墨不多,而是直接切入“如何分析”的核心。这无疑加速了资深研究人员的阅读进程,但对于新手来说,可能需要在阅读时手边常备一本编程参考书。当然,这也可以被视为一种优点——它定位明确,目标用户清晰,没有为了迎合所有人群而稀释其核心价值。对于希望快速成长为能独立设计和执行复杂基因表达数据分析的科研人员而言,这本书的定位精准得无可挑剔,它提供的知识密度和深度,绝对物超所值,是书架上不可或缺的工具书。
评分从内容的前沿性和覆盖面的广度来看,这本书无疑走在了领域的前沿。它并没有满足于介绍那些经典或成熟的分析流程,而是将最新的、尚未完全“标准化”的研究热点也纳入了探讨范围。例如,它对单细胞数据分析中新兴的降维技术和细胞类型注释策略的讨论,就展现了作者持续跟踪学术动态的能力。很多同行都在摸索如何处理单细胞数据带来的高维度和稀疏性问题,而这本书提供了一个结构化的视角去审视这些挑战,并展示了当前社区内几种主流解决方案的优劣势比较。这种前瞻性,对于希望将研究成果发表在顶级期刊上的科研工作者来说至关重要。毕竟,评审人往往会关注你是否采用了当前最适合、最先进的分析手段。这本书无疑为我们提供了坚实的理论基础和操作指南,去自信地采纳这些尖端技术。它成功地架设了一座理论与实践、经典与前沿之间的桥梁,让读者在掌握核心技能的同时,不至于在快速迭代的技术浪潮中迷失方向。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有