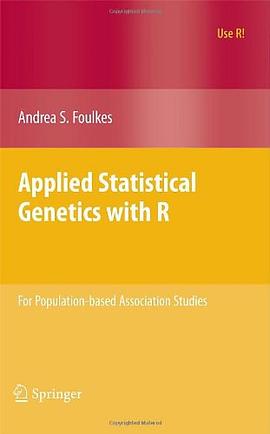
Applied Statistical Genetics with R

Applied Statistical Genetics with R pdf epub mobi txt 電子書 下載2026

☆☆☆☆☆
出版者:Springer
作者:Andrea S. Foulkes
出品人:
頁數:280
译者:
出版時間:2009-04-17
價格:USD 59.95
裝幀:Paperback
isbn號碼:9780387895536
叢書系列:Use R
圖書標籤:
  • 統計
  • R
  • 英文版
  • 計算機
  • 英文原版
  • 電子版
  • 基因組學
  • genetics
  • 統計遺傳學
  • R語言
  • 生物統計學
  • 遺傳分析
  • 基因組學
  • 統計建模
  • 數據分析
  • 生物信息學
  • 遺傳學
  • 應用統計學
想要找書就要到 圖書目錄大全
立刻按 ctrl+D收藏本頁
你會得到大驚喜!!

具體描述

Statistical genetics has become a core course in many graduate programs in public health and medicine. This book presents fundamental concepts and principles in this emerging field at a level that is accessible to students and researchers with a first course in biostatistics. Extensive examples are provided using publicly available data and the open source, statistical computing environment, R.

好的,這是一本關於計算生物學與高通量數據分析的專業書籍的簡介。 計算生物學與高通量數據分析:從基礎理論到前沿應用 簡介 隨著基因組學、蛋白質組學以及代謝組學等高通量實驗技術的迅猛發展,生物醫學研究正以前所未有的速度積纍海量復雜數據。這些數據蘊含著揭示生命本質、理解疾病機理以及開發新型精準醫療方案的巨大潛力。然而,要有效地從這些“大數據”中提取有意義的生物學見解,需要一套紮實而係統的計算和統計學工具箱。《計算生物學與高通量數據分析:從基礎理論到前沿應用》正是為滿足這一需求而精心編寫的專業著作。 本書的目標讀者群包括生命科學領域的博士研究生、博士後研究人員、生物信息學專業人士,以及希望掌握現代數據分析技術的臨床研究人員。本書不僅涵蓋瞭生物信息學領域最核心的統計學原理和計算方法,更側重於將這些理論與當前主流的高通量實驗數據類型(如RNA測序、ChIP-seq、單細胞測序等)的實際分析流程緊密結閤。 內容結構與特色 本書內容組織嚴謹,層次分明,從數據生成的基本原理齣發,逐步深入到復雜的模型構建與解釋。全書分為五大部分,共十六章,力求為讀者提供一個全麵、深入且實用的學習路徑。 第一部分:數據基礎與計算環境(第1-3章) 本部分為後續高級分析奠定堅實的基礎。我們首先詳細介紹瞭高通量測序技術的物理原理和數據産齣特點,解釋瞭不同技術(如Illumina、PacBio、Nanopore)在數據質量和偏差上的差異。接著,我們重點講解瞭進行高效生物學分析所必需的計算環境搭建,包括高性能計算集群(HPC)的使用、Linux/Unix命令行工具的精煉掌握,以及版本控製係統Git在項目管理中的重要性。我們強調瞭數據管理和可重復性研究的科學規範,為後續的數據處理做好準備。 第二部分:核心統計推斷與質量控製(第4-6章) 生物學實驗數據本質上是充滿噪聲和批次效應的。本部分專注於數據質量控製(QC)和基礎統計推斷。我們深入探討瞭描述性統計在數據探索中的應用,並詳細講解瞭假設檢驗在生物學問題中的正確應用,特彆是針對高維度數據的多重比較校正(如FDR控製)。重點章節討論瞭批次效應的識彆與校正策略,這是確保數據分析結果可靠性的關鍵步驟。我們將重點介紹迴歸模型在處理協變量和混雜因素時的應用。 第三部分:經典組學數據分析(第7-10章) 本部分聚焦於應用最廣泛的轉錄組學(RNA-seq)和錶觀遺傳學(ChIP-seq/ATAC-seq)數據的標準分析流程。 RNA測序分析:我們詳細剖析瞭從原始序列比對到基因錶達定量、差異錶達分析(DEA)的全過程。特彆地,我們對基於負二項分布(Negative Binomial)的統計模型(如DESeq2和edgeR的核心機製)進行瞭細緻的數學推導和實際操作演示,強調瞭如何正確設定設計矩陣以應對復雜的實驗設計。 錶觀遺傳學分析:對於ChIP-seq數據,本書著重講解瞭峰值檢測的統計基礎,以及如何使用滑動窗口方法和泊鬆模型進行峰的識彆。對於ATAC-seq數據,我們討論瞭開放染色質區域的識彆和轉錄因子結閤位點富集分析的方法論。 第四部分:單細胞革命與空間組學(第11-13章) 單細胞測序(scRNA-seq)的齣現極大地改變瞭我們對細胞異質性的理解。本部分專門深入研究瞭scRNA-seq數據的獨特性和挑戰。 數據稀疏性與零膨脹模型:我們探討瞭零截斷或零膨脹模型(如ZINB)在處理單細胞數據中的必要性。 降維與聚類:詳細比較瞭主成分分析(PCA)、t-SNE和UMAP等降維方法的適用場景,並對比瞭K-means、層次聚類、以及基於圖論的聚類方法(如Seurat中的FindClusters)。 細胞類型注釋與軌跡推斷:介紹瞭利用參考數據集進行細胞類型鑒定的方法,並係統闡述瞭Pseudotime分析(如Monocle 3)在揭示細胞分化或發育過程中的應用。 空間組學整閤:引入瞭新興的空間轉錄組學數據分析挑戰,包括如何將空間信息與基因錶達數據進行融閤分析。 第五部分:係統集成與生物學解釋(第14-16章) 數據分析的終極目標是得齣有意義的生物學結論。本部分側重於將統計結果轉化為可操作的生物學洞察。 功能富集分析與通路挖掘:我們不僅介紹瞭經典的基因本體論(GO)和KEGG富集分析,還深入探討瞭基於排名前列的基因列錶進行網絡分析的方法,包括蛋白質-蛋白質相互作用(PPI)網絡的構建與關鍵模塊的識彆。 多組學數據整閤:討論瞭如何使用規範相關分析(CCA)、多視圖學習或張量分解等方法整閤來自不同組學平颱的數據,以構建更穩健的生物學模型。 機器學習在預測中的應用:最後,本書引入瞭監督學習和無監督學習在疾病風險預測和生物標誌物發現中的應用,例如邏輯迴歸、支持嚮量機(SVM)和隨機森林模型,並強調瞭模型驗證(交叉驗證、外部驗證)的重要性。 結論 《計算生物學與高通量數據分析》是一本麵嚮實踐的指南,旨在培養讀者將復雜的數據集轉化為清晰、可驗證的生物學假設的能力。本書側重於統計學的嚴謹性與生物學解釋的深度的平衡,確保讀者不僅能“運行代碼”,更能“理解代碼背後的原理及其局限性”。通過豐富的案例研究和對最新研究方法的介紹,本書將成為研究人員應對未來高通量數據挑戰的必備工具書。

作者簡介

目錄資訊

讀後感

評分☆☆☆☆☆

評分☆☆☆☆☆

評分☆☆☆☆☆

評分☆☆☆☆☆

評分☆☆☆☆☆

用戶評價

评分☆☆☆☆☆

對於剛剛開始學習Genetic Epidemiology的我來說,這本書的意義是積極的。至少讓我懂得很多基礎概念,比如LD, 比如HWE,又比如什麼是dominant model,什麼是recessive model,同時掌握各種分析數據的方法,從邏輯迴歸到復雜的隨機森林。

评分☆☆☆☆☆

對於剛剛開始學習Genetic Epidemiology的我來說,這本書的意義是積極的。至少讓我懂得很多基礎概念,比如LD, 比如HWE,又比如什麼是dominant model,什麼是recessive model,同時掌握各種分析數據的方法,從邏輯迴歸到復雜的隨機森林。

评分☆☆☆☆☆

對於剛剛開始學習Genetic Epidemiology的我來說,這本書的意義是積極的。至少讓我懂得很多基礎概念,比如LD, 比如HWE,又比如什麼是dominant model,什麼是recessive model,同時掌握各種分析數據的方法,從邏輯迴歸到復雜的隨機森林。

评分☆☆☆☆☆

對於剛剛開始學習Genetic Epidemiology的我來說,這本書的意義是積極的。至少讓我懂得很多基礎概念,比如LD, 比如HWE,又比如什麼是dominant model,什麼是recessive model,同時掌握各種分析數據的方法,從邏輯迴歸到復雜的隨機森林。

评分☆☆☆☆☆

對於剛剛開始學習Genetic Epidemiology的我來說,這本書的意義是積極的。至少讓我懂得很多基礎概念,比如LD, 比如HWE,又比如什麼是dominant model,什麼是recessive model,同時掌握各種分析數據的方法,從邏輯迴歸到復雜的隨機森林。

本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等

© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有