

具体描述
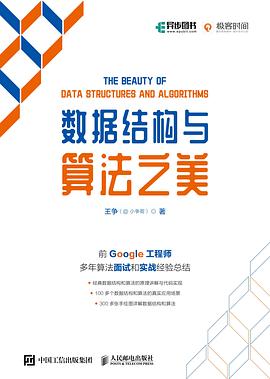
本书结合实际应用场景讲解数据结构和算法,涵盖常用、常考的数据结构和算法的原理讲解、代码实现和应用场景等。
本书分为11章。第1章介绍复杂度分析方法。第2章介绍数组、链表、栈和队列这些基础的线性表数据结构。第3章介绍递归编程技巧、8种经典排序、二分查找及二分查找的变体问题。第4章介绍哈希表、位图、哈希算法和布隆过滤器。第5章介绍树相关的数据结构,包括二叉树、二叉查找树、平衡二叉查找树、递归树和B+树。第6章介绍堆,以及堆的各种应用,包括堆排序、优先级队列、求Top K、求中位数和求百分位数。第7章介绍跳表、并查集、线段树和树状数组这些比较高级的数据结构。第8章介绍字符串匹配算法,包括BF算法、RK算法、BM算法、KMP算法、Trie树和AC自动机。第9章介绍图及相关算法,包括深度优先搜索、广度优先搜索、拓扑排序、Dijkstra算法、Floyd算法、A*算法、最小生成树算法、最大流算法和最大二分匹配等。第10章介绍4种算法思想,包括贪心、分治、回溯和动态规划。第11章介绍4个经典项目中的数据结构和算法的应用,包括Redis、搜索引擎、鉴权限流和短网址服务。另外,附录A为书中的思考题的解答。
尽管本书的大部分代码采用Java语言编写,但本书讲解的知识与具体编程语言无关,因此,本书不但适合各种类型的研发工程师,而且可以作为高校计算机相关专业师生的学习用书和培训学校的教材。
作者简介
王争,前Google工程师,微信公众号【小争哥】作者,GitHub上算法教程Star数排名前列。热衷分享,致力于通俗易懂地讲解数据结构和算法,帮助广大程序员攻克算法学习、算法刷题、算法面试三项难关。
目录信息
1.1复杂度分析(上):如何分析代码的执行效率和资源消耗 2
1.1.1复杂度分析的意义 2
1.1.2大O复杂度表示法 2
1.1.3时间复杂度分析方法 4
1.1.4几种常见的时间复杂度量级 5
1.1.5空间复杂度分析方法 7
1.1.6内容小结 7
1.1.7思考题 8
1.2复杂度分析(下):详解最好、最坏、平均、均摊这4种时间复杂度 8
1.2.1最好时间复杂度和最坏时间复杂度 8
1.2.2平均时间复杂度 9
1.2.3均摊时间复杂度 10
1.2.4内容小结 11
1.2.5思考题 12
第2章数组、链表、栈和队列 13
2.1数组(上):为什么数组的下标一般从0开始编号 14
2.1.1数组的定义 14
2.1.2寻址公式和随机访问特性 15
2.1.3低效的插入和删除操作 15
2.1.4警惕数组访问越界问题 16
2.1.5容器能否完全替代数组 17
2.1.6解答本节开篇问题 18
2.1.7内容小结 18
2.1.8思考题 18
2.2数组(下):数据结构中的数组和编程语言中的数组的区别 19
2.2.1C/C++中数组的实现方式 19
2.2.2Java中数组的实现方式 20
2.2.3JavaScript中数组的实现方式 22
2.2.4内容小结 23
2.2.5思考题 23
2.3链表(上):如何基于链表实现LRU缓存淘汰算法 23
2.3.1链表的底层存储结构 24
2.3.2链表的定义和操作 24
2.3.3链表的变形结构 26
2.3.4链表与数组的性能对比 28
2.3.5解答本节开篇问题 29
2.3.6内容小结 29
2.3.7思考题 30
2.4链表(下):借助哪些技巧可以轻松地编写链表相关的复杂代码 30
2.4.1技巧1:理解指针或引用的含义 30
2.4.2技巧2:警惕指针丢失和内存泄露 30
2.4.3技巧3:利用“哨兵”简化代码 31
2.4.4技巧4:留意边界条件和特殊情况 33
2.4.5技巧5:举例画图,辅助思考 34
2.4.6技巧6:多写多练,没有捷径 34
2.4.7内容小结 34
2.4.8思考题 35
2.5栈:如何实现浏览器的前进和后退功能 35
2.5.1栈的定义 35
2.5.2顺序栈和链式栈 35
2.5.3支持动态扩容的顺序栈 36
2.5.4栈在函数调用中的应用 37
2.5.5栈在表达式求值中的应用 38
2.5.6栈在括号匹配中的应用 38
2.5.7解答本节开篇问题 39
2.5.8内容小结 40
2.5.9思考题 40
2.6队列:如何实现线程池等有限资源池的请求排队功能 40
2.6.1队列的定义 40
2.6.2顺序队列和链式队列 41
2.6.3循环队列 42
2.6.4阻塞队列和并发队列 44
2.6.5解答本节开篇问题 44
2.6.6内容小结 45
2.6.7思考题 45
第3章递归、排序、二分查找 46
3.1递归:如何用3行代码找到“最终推荐人” 47
3.1.1什么是递归 47
3.1.2递归需要满足的3个条件 48
3.1.3如何编写递归代码 48
3.1.4编写递归代码的难点 49
3.1.5警惕递归代码出现堆栈溢出 49
3.1.6警惕递归代码的重复计算问题 50
3.1.7将递归代码改写为非递归代码 51
3.1.8解答本节开篇问题 52
3.1.9内容小结 52
3.1.10思考题 52
3.2尾递归:如何借助尾递归避免递归过深导致的堆栈溢出 53
3.2.1递归产生堆栈溢出的原因 53
3.2.2什么样的递归代码可以改写为尾递归 54
3.2.3尾递归真的可以避免堆栈溢出吗 54
3.2.4思考题 55
3.3排序算法基础:从哪几个方面分析排序算法 55
3.3.1排序算法的执行效率 55
3.3.2排序算法的内存消耗 56
3.3.3排序算法的稳定性 56
3.3.4内容小结 57
3.3.5思考题 57
3.4O(n2)排序:为什么插入排序比冒泡排序更受欢迎 58
3.4.1冒泡排序 58
3.4.2插入排序 60
3.4.3选择排序 62
3.4.4解答本节开篇问题 63
3.4.5内容小结 64
3.4.6思考题 64
3.5O(nlogn)排序:如何借助快速排序思想快速查找第K大元素 64
3.5.1归并排序的原理和实现 64
3.5.2归并排序的性能分析 66
3.5.3快速排序的原理和实现 68
3.5.4快速排序的性能分析 70
3.5.5解答本节开篇问题 71
3.5.6内容小结 72
3.5.7思考题 72
3.6线性排序:如何根据年龄给100万个用户排序 72
3.6.1桶排序 73
3.6.2计数排序 74
3.6.3基数排序 76
3.6.4解答本节开篇问题 77
3.6.5内容小结 77
3.6.6思考题 77
3.7排序优化:如何实现一个高性能的通用的排序函数 78
3.7.1如何选择合适的排序算法 78
3.7.2如何优化快速排序 79
3.7.3排序函数举例分析 79
3.7.4内容小结 80
3.7.5思考题 80
3.8二分查找:如何用最省内存的方式实现快速查找功能 80
3.8.1无处不在的二分思想 81
3.8.2O(logn)惊人的查找速度 82
3.8.3二分查找的递归与非递归实现 82
3.8.4二分查找应用场景的局限性 83
3.8.5解答本节开篇问题 84
3.8.6内容小结 85
3.8.7思考题 85
3.9二分查找的变体:如何快速定位IP地址对应的归属地 85
3.9.1什么是二分查找变体问题 86
3.9.2变体问题1:查找第一个值等于给定值的元素 86
3.9.3变体问题2:查找最后一个值等于给定值的元素 88
3.9.4变体问题3:查找第一个值大于或等于给定值的元素 88
3.9.5变体问题4:查找最后一个值小于或等于给定值的元素 89
3.9.6解答本节开篇问题 89
3.9.7内容小结 90
3.9.8思考题 90
第4章哈希表、位图和哈希算法 91
4.1哈希表(上):Word软件的单词拼写检查功能是如何实现的 92
4.1.1哈希思想 92
4.1.2哈希函数 93
4.1.3哈希冲突 93
4.1.4解答本节开篇问题 95
4.1.5内容小结 95
4.1.6思考题 96
4.2哈希表(中):如何打造一个工业级的哈希表 96
4.2.1设计哈希函数 96
4.2.2解决装载因子过大的问题 97
4.2.3避免低效的扩容 98
4.2.4选择合适的冲突解决方法 99
4.2.5工业级的哈希表举例分析 100
4.2.6解答本节开篇问题 100
4.2.7内容小结 101
4.2.8思考题 101
4.3哈希表(下):如何利用哈希表优化LRU缓存淘汰算法 101
4.3.1LRU缓存淘汰算法 102
4.3.2Java LinkedHashMap 104
4.3.3内容小结 105
4.3.4思考题 105
4.4位图:如何实现网页“爬虫”中的网址链接去重功能 106
4.4.1基于哈希表的解决方案 106
4.4.2基于位图的解决方案 106
4.4.3基于布隆过滤器的解决方案 108
4.4.4回答本节开篇问题 110
4.4.5内容小结 110
4.4.6思考题 111
4.5哈希算法:如何防止数据库脱库后用户信息泄露 111
4.5.1哈希算法介绍 111
4.5.2应用1:安全加密 112
4.5.3应用2:唯一标识 113
4.5.4应用3:数据校验 113
4.5.5应用4:哈希函数 113
4.5.6应用5:负载均衡 114
4.5.7应用6:数据分片 114
4.5.8应用7:分布式存储 115
4.5.9解答本节开篇问题 116
4.5.10内容小结 116
4.5.11思考题 116
第5章树 117
5.1树和二叉树:什么样的二叉树适合用数组存储 118
5.1.1树的定义 118
5.1.2二叉树的定义 118
5.1.3二叉树的存储 119
5.1.4二叉树的遍历 120
5.1.5解答本节开篇问题 122
5.1.6内容小结 122
5.1.7思考题 122
5.2二叉查找树:相比哈希表,二叉查找树有何优势 122
5.2.1二叉查找树的定义和操作 123
5.2.2支持重复数据的二叉查找树 126
5.2.3二叉查找树的性能分析 126
5.2.4解答本节开篇问题 127
5.2.5内容小结 128
5.2.6思考题 128
5.3平衡二叉查找树:为什么红黑树如此受欢迎 128
5.3.1平衡二叉查找树的定义 128
5.3.2红黑树的定义 129
5.3.3红黑树的性能分析 129
5.3.4解答本节开篇问题 130
5.3.5内容小结 130
5.3.6思考题 131
5.4递归树:如何借助树求递归算法的时间复杂度 131
5.4.1递归树时间复杂度分析法 131
5.4.2实战1:快速排序的时间复杂度分析 132
5.4.3实战2:斐波那契数列的时间复杂度分析 133
5.4.4实战3:全排列的时间复杂度分析 133
5.4.5内容小结 135
5.4.6思考题 135
5.5B+树:MySQL数据库索引是如何实现的 135
5.5.1典型需求:按值查询和按区间查询 135
5.5.2基于哈希表和二叉查找树的解决方案 136
5.5.3基于B+树的解决方案 136
5.5.4内容小结 139
5.5.5思考题 140
第6章堆 141
6.1堆:如何维护动态集合的最值 142
6.1.1堆的定义 142
6.1.2堆的存储 142
6.1.3往堆中插入元素 143
6.1.4删除堆顶元素 144
6.1.5删除任意元素 145
6.1.6堆的性能分析 145
6.1.7解答本节开篇问题 145
6.1.8内容小结 146
6.1.9思考题 146
6.2堆排序:为什么说堆排序没有快速排序快 147
6.2.1堆排序之建堆 147
6.2.2堆排序之排序 149
6.2.3堆排序的性能分析 149
6.2.4解答本节开篇问题 150
6.2.5内容小结 150
6.2.6思考题 151
6.3堆的应用:如何快速获取Top 10热门搜索关键词 151
6.3.1堆的应用1:优先级队列 151
6.3.2堆的应用2:求Top K 152
6.3.3堆的应用3:求中位数和百分位数 153
6.3.4解答本节开篇问题 155
6.3.5内容小结 155
6.3.6思考题 156
第7章跳表、并查集、线段树和树状数组 157
7.1跳表:Redis中的有序集合类型是如何实现的 158
7.1.1 跳表的由来 158
7.1.2 用跳表查询到底有多快 159
7.1.3 跳表是不是很浪费内存 160
7.1.4 高效插入和删除 161
7.1.5 跳表索引动态更新 162
7.1.6 解答本节开篇问题 162
7.1.7 内容小结 163
7.1.8 思考题 163
7.2并查集:路径压缩和按秩合并这两个优化是否冲突 163
7.2.1 并查集的由来 163
7.2.2 基于链表的实现思路 164
7.2.3 基于树的实现思路 166
7.2.4 内容小结 168
7.2.5 思考题 168
7.3线段树:如何查找猎聘网中积分排在第K位的猎头 168
7.3.1 区间统计问题 169
7.3.2 线段树的其他应用 172
7.3.3 解答本节开篇问题 174
7.3.4 内容小结 174
7.3.5 思考题 174
7.4树状数组:如何实现一个高性能、低延迟的实时排行榜 174
7.4.1 “前缀和”问题 175
7.4.2 树状数组与线段树的对比 177
7.4.3 解答本节开篇问题 177
7.4.4 内容小结 178
7.4.5 思考题 178
第8章字符串匹配算法 179
8.1BF算法:编程语言中的查找、替换函数是怎样实现的 180
8.1.1 BF算法的原理与实现 180
8.1.2 BF算法的性能分析 181
8.1.3 解答本节开篇问题 181
8.1.4 内容小结 182
8.1.5 思考题 182
8.2RK算法:如何借助哈希算法实现高效的字符串匹配 182
8.2.1 RK算法的原理与实现 182
8.2.2 RK算法的性能分析 183
8.2.3 内容小结 184
8.2.4 思考题 184
8.3BM算法:如何实现文本编辑器中的查找和替换功能 185
8.3.1 BM算法的核心思想 185
8.3.2 BM算法的原理分析 186
8.3.3 BM算法的代码实现 188
8.3.4 BM算法的性能分析 192
8.3.5 解答本节开篇问题 193
8.3.6 内容小结 193
8.3.7 思考题 193
8.4KMP算法:如何借助BM算法理解KMP算法 194
8.4.1 KMP算法的基本原理 194
8.4.2 失效函数的计算方法 196
8.4.3 KMP算法的性能分析 197
8.4.4 内容小结 198
8.4.5 思考题 198
8.5Trie树:如何实现搜索引擎的搜索关键词提示功能 198
8.5.1 Trie树的定义 199
8.5.2 Trie树的代码实现 200
8.5.3 Trie树的性能分析 201
8.5.4 Trie树与哈希表、红黑树的比较 202
8.5.5 解答本节开篇问题 202
8.5.6 内容小结 203
8.5.7 思考题 204
8.6AC自动机:如何用多模式串匹配实现敏感词过滤 204
8.6.1 基于单模式串的敏感词过滤 204
8.6.2 基于Trie树的敏感词过滤 205
8.6.3 基于AC自动机的敏感词过滤 205
8.6.4 AC自动机的性能分析 208
8.6.5 内容小结 209
8.6.6 思考题 209
第9章图 210
9.1图的表示:如何存储微博、微信等社交网络中的好友关系 211
9.1.1 图的定义 211
9.1.2 邻接矩阵的存储方法 212
9.1.3 邻接表的存储方法 213
9.1.4 解答本节开篇问题 214
9.1.5 内容小结 215
9.1.6 思考题 215
9.2深度优先搜索和广度优先搜索:如何找出社交网络中的三度好友关系 216
9.2.1 什么是搜索算法 216
9.2.2 广度优先搜索 217
9.2.3 深度优先搜索 219
9.2.4 解答本节开篇问题 220
9.2.5 内容小结 220
9.2.6 思考题 220
9.3拓扑排序:如何确定代码源文件的编译依赖关系 221
9.3.1 什么是拓扑排序 221
9.3.2 利用Kahn算法实现拓扑排序 222
9.3.3 利用深度优先搜索实现拓扑排序 222
9.3.4 利用拓扑排序检测环 223
9.3.5 解答本节开篇问题 224
9.3.6 内容小结 224
9.3.7 思考题 224
9.4单源最短路径:地图软件如何“计算”最优出行路线 225
9.4.1 最短路径算法介绍 225
9.4.2 Dijkstra算法的原理与实现 225
9.4.3 Dijkstra算法的性能分析 228
9.4.4 Dijkstra算法思想的应用 228
9.4.5 解答本节开篇问题 229
9.4.6 内容小结 230
9.4.7 思考题 230
9.5多源最短路径:如何利用Floyd算法解决传递闭包问题 231
9.5.1 Floyd算法的原理与实现 231
9.5.2 Floyd算法的性能分析 232
9.5.3 利用Floyd算法求解传递闭包 232
9.5.4 内容小结 233
9.5.5 思考题 233
9.6启发式搜索:如何用A*算法实现游戏中的寻路功能 233
9.6.1 什么是次优路线 234
9.6.2 A*算法的原理与实现 234
9.6.3 A*算法与Dijkstra算法的对比 236
9.6.4 解答本节开篇问题 237
9.6.5 内容小结 237
9.6.6 思考题 238
9.7最小生成树:如何随机生成游戏中的迷宫地图 238
9.7.1 什么是最小生成树 238
9.7.2 Kruskal算法的原理与实现 239
9.7.3 Prim算法的原理与实现 240
9.7.4 解答本节开篇问题 242
9.7.5 内容小结 244
9.7.6 思考题 245
9.8最大流:如何解决单身交友联谊中的最多匹配问题 245
9.8.1 什么是最大流 245
9.8.2 Ford-Fulkerson方法 246
9.8.3 Edmonds-Karp算法 247
9.8.4 最大二分匹配 249
9.8.5 解答本节开篇问题 249
9.8.6 内容小结 249
9.8.7 思考题 250
第10章贪心、分治、回溯和动态规划 251
10.1贪心算法:如何利用贪心算法实现霍夫曼编码 252
10.1.1 如何理解贪心算法 252
10.1.2 贪心算法的应用示例 253
10.1.3 解答本节开篇问题 255
10.1.4 内容小结 256
10.1.5 思考题 256
10.2分治算法:谈一谈大规模计算框架MapReduce中的分治思想 256
10.2.1 如何理解分治算法 257
10.2.2 分治算法的应用示例 257
10.2.3 分治算法在大数据处理中的应用 259
10.2.4 解答本节开篇问题 259
10.2.5 内容小结 260
10.2.6 思考题 260
10.3回溯算法:从电影《蝴蝶效应》中学习回溯算法的核心思想 260
10.3.1 如何理解回溯算法 261
10.3.2 八皇后问题 261
10.3.3 0-1背包问题 262
10.3.4 正则表达式匹配问题 263
10.3.5 内容小结 264
10.3.6 思考题 264
10.4初识动态规划:如何巧妙解决“双11”购物时的凑单问题 264
10.4.1 动态规划的学习路线 265
10.4.2 利用动态规划解决0-1背包问题 265
10.4.3 0-1背包问题的升级版 269
10.4.4 解答本节开篇问题 270
10.4.5 内容小结 271
10.4.6 思考题 272
10.5动态规划理论:彻底理解最优子结构、无后效性和重复子问题 272
10.5.1 “一个模型和三个特征”理论介绍 272
10.5.2 “一个模型和三个特征”的应用示例 273
10.5.3 动态规划的两种解题方法 274
10.5.4 4种算法思想的比较分析 277
10.5.5 内容小结 277
10.5.6 思考题 278
10.6动态规划实战:如何实现搜索引擎中的拼写纠错功能 278
10.6.1 如何量化两个字符串的相似度 278
10.6.2 如何通过编程计算莱文斯坦距离 279
10.6.3 如何通过编程计算最长公共子串长度 281
10.6.4 解答本节开篇问题 282
10.6.5 内容小结 283
10.6.6 思考题 283
第11章数据结构和算法实战 284
11.1实战1:剖析Redis的常用数据类型对应的数据结构 285
11.1.1 Redis数据库介绍 285
11.1.2 列表(list) 285
11.1.3 哈希(hash) 286
11.1.4 集合(set) 286
11.1.5 有序集合(sorted set) 287
11.1.6 数据结构的持久化问题 287
11.1.7 总结和引申 288
11.1.8 思考题 288
11.2实战2:剖析搜索引擎背后的经典数据结构和算法 288
11.2.1 搜索引擎系统的整体介绍 288
11.2.2 搜集 289
11.2.3 分析 290
11.2.4 索引 292
11.2.5 查询 292
11.2.6 总结和引申 293
11.2.7 思考题 293
11.3实战3:剖析微服务鉴权和限流背后的数据结构和算法 293
11.3.1 鉴权背景介绍 294
11.3.2 如何实现快速鉴权 294
11.3.3 限流背景介绍 297
11.3.4 如何实现精准限流 297
11.3.5 总结和引申 298
11.3.6 思考题 299
11.4实战4:用学过的数据结构和算法实现短网址服务 299
11.4.1 短网址服务的整体介绍 299
11.4.2 通过哈希算法生成短网址 299
11.4.3 通过ID生成器生成短网址 302
11.4.4 总结和引申 303
11.4.5 思考题 303
附录A思考题答案 304
· · · · · · (收起)
读后感
作为一个码农,可能大多数同学的想法是拿数据结构,算法,设计模式来攻大厂的城,实不相瞒,我是看中了争哥这套理论的实用性,从这个角度来看,争哥的书对我来说帮助还是巨大的,嘻嘻😁 同为Java,跟算法4还是有区别的,算法4的理论性,学术性可能更浓厚一点,还是那句话,如...
评分最早接触到王争老师数据结构与算法之美相关课程是的网络教程 ,全网异常火爆,虽然接触C编程和python有几年了,但当时还不是很重视算法,没有深入学习,所以也不是很上心。随着编程需要慢慢就会重视算法,算法对于程序员是基本功,就好比建房子一样,地基一定要牢固 。本书的代...
评分小争哥的这本书可以说早已非常有名,关注他的算法专栏的也非常多。 感觉本书的最大特点就是结合实际,当看到算法书这一个单词,首先的感觉就是“数学”、“枯燥”,而本书结合日常工作中的实际问题,用Java语言中的数组、链表等数据结构类进行一步步展示,贴合实际,从而使读者...
评分读过小争哥设计模式的专栏,本想继续他的算法专栏,结果偶然发现出书了。在我认为,出版的纸书一般都会比电子的更加缜密一些,无论从排版、配图还有内容设计方面,非常期待的一本书。 小争哥的作品,充分体现了他作为资深的Google工程师扎实的基础功底和程序设计思维。 “针对...
评分我一直以为算法是什么很高深的东西,从初始编程到现在都没研究过算法,对算法的印象之停留在上学教的各种排序,与其说是会算法不如说是知道算法这个东西。这本书对我来说真的是出现的很及时,看了前面几章,写的很详细,从最基础的开始讲起,非常非常适合零基础的初学者,内容...
用户评价
这本书给我的最大感受就是“体系化和连贯性”。很多算法书都是零散地介绍各种算法,读完后感觉知识点像散落的珍珠,难以串联。但这本《数据结构与算法之美》构建了一个非常坚实的知识框架。它清晰地展示了从基础的线性结构到复杂的图论问题,每一种数据结构是如何自然地演化和适配特定场景的。例如,它在介绍完树的遍历后,立刻引出了堆和优先队列的概念,逻辑过渡极其自然,让你明白堆的出现是为了解决特定类型的“优先级”问题,而不是凭空出现的工具。这种“因果推导”式的讲解方式,极大地帮助我构建了稳固的知识网络。现在当我面对一个新问题时,我能迅速在大脑中扫描出最合适的“结构载体”,而不是盲目地套用算法模板。
评分我必须得吐槽一下,这本书的难度曲线有点“陡峭”,但绝对是值得攀登的。对于初学者来说,前几章可能需要反复咀嚼,因为它不像某些入门书籍那样,把一切都简化到失去了精髓。书中对某些高级数据结构(比如B树或红黑树的平衡机制)的剖析,深度和广度都达到了专业级别的水准。我印象特别深的是关于时间复杂度和空间复杂度的分析部分,作者没有满足于给出Big O表示法,而是深入探讨了常数因子和实际运行环境对性能的影响,这一点非常严谨,对于需要进行性能优化的资深开发者来说,提供了更细致的视角。我花了大量时间去自己手写和调试书中提到的那些复杂度验证的小程序,每一次成功运行,都让我对算法的效率有了更直观的认识。这本书的价值在于,它不是教你如何快速通过面试,而是教你如何成为一个真正懂得计算理论的工程师。
评分坦白说,我对这本书的整体体验是“惊喜多于预期”。我原本以为这又是一本堆砌公式和代码的参考书,但读下来发现它更像是一本“武功秘籍”的解读,侧重于“美”和“思想”的传达。它并没有陷入在某些特定语言的语法细节中纠缠,而是把核心的算法思想剥离出来,用一种非常优雅的方式呈现。我尤其欣赏作者在讲解贪心算法和动态规划时的那种哲学思辨——如何判断最优子结构,如何构造最优解。这些不仅仅是技术层面的探讨,更像是对解决问题思维模式的一种重塑。书中穿插的一些历史典故和算法设计者的故事,也让冰冷的逻辑多了几分人情味。读完后,我感觉自己对算法的理解不再是停留在“会写代码”的层面,而是上升到了“如何优雅地设计解决方案”的高度。这对于提升我的工程实践能力,是无价的财富。
评分说实话,这本书的“美感”确实名副其实。它的文字里有一种罕见的宁静和力量感,让人在阅读复杂的算法推导时也能保持心境平和。我特别喜欢作者在讲解分治策略时所采用的类比,那种将大问题分解为小问题的思想,仿佛渗透到了文本的每一个角落。这不是那种追求速度和效率至上的教材,它更像是一篇关于计算艺术的散文。它教会我的不仅仅是算法,更是一种面对复杂系统的耐心和洞察力。每当我感到编程陷入瓶颈时,重新翻阅其中关于“平衡”与“效率”的章节,总能重新找回最初的热情和解决问题的清晰思路。这本书对于那些追求技术深度和审美的人来说,绝对是一本值得收藏和反复研读的宝典。
评分这本《数据结构与算法之美》简直是我的“救命稻草”!我之前学算法的时候,感觉就像在看一本天书,各种概念混在一起,根本不知道它们之间有什么关联。直到我翻开这本书,那种豁然开朗的感觉真是太棒了。作者的叙述方式非常生动形象,不是那种干巴巴的教科书式语言。比如讲到链表的时候,他不是简单地告诉你节点和指针是什么,而是用了一个非常贴近生活的比喻,让我一下子就理解了链表在内存中的布局和操作逻辑。尤其是对递归的讲解,简直是神来之笔,以前我觉得递归是最玄乎的概念,现在我能清晰地在脑海中描绘出函数调用栈的运行过程。而且,这本书的排版和图示设计也很有心,那些流程图和复杂度分析的表格,做得非常清晰直观,比我之前看的任何资料都要好懂。读完对基础数据结构的理解,我的自信心都提升了一大截,感觉编程路上不再有那么多的“拦路虎”了。
评分翻译的也很好,是本好书,如果有想学算法的小伙伴,推荐大家入手。
评分感觉车轱辘话来回说,那本《设计模式之美》也是,语言不够精简。。
评分极好的书,鞭辟入里。
评分小争哥将算法和数据结构讲得深入浅出,书上的内容比专栏增加了不少
评分对算法和数据结构的学习,是读者对逻辑思维能力的锻炼。对于程序员,为重要的能力是解决问题的能力。学习算法、掌握数据结构的应用,可以让读者具备科学的思维方式。这本书通俗易懂,推荐
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有