
Statistics with STATA pdf epub mobi txt 电子书 下载 2026
- STATA
- 软件
- 统计
- 原版
- statistics
- Stata
- 统计学
- 计量经济学
- Stata
- 数据分析
- 回归分析
- 统计建模
- 应用统计
- 社会科学
- 经济学
- 统计软件

具体描述
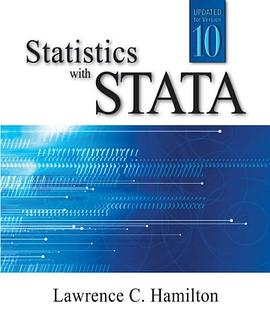
For professional researchers and casual readers alike, STATISTICS WITH STATA opens the door to the full use of the popular Stata programaa fast, flexible, and easy-to-use environment for data management and statistics analysis. Now integrating Stata's impressive new graphics, this comprehensive book presents hundreds of examples showing how you can apply Stata to accomplish a wide variety of tasks. Like Stata itself, STATISTICS WITH STATA will make it easier for you to move fluidly through the world of modern data analysis.
作者简介
目录信息
读后感
用户评价
这本书最大的价值,我认为在于它对STATA的高级功能的覆盖和整合能力。它不仅仅是一个基础的命令速查手册,而是真正触及了计量经济学和高级统计分析的前沿领域。例如,书中对时间序列分析(ARIMA, GARCH模型)和生存分析(Kaplan-Meier, Cox回归)的介绍,其深度已经超越了我预期的入门级读物范围。作者在讲解这些高级模型时,并没有简单地罗列命令,而是花了大量篇幅讨论了模型选择的逻辑和结果的稳健性检验。我尤其欣赏它对内生性(Endogeneity)问题的讨论,对工具变量法(IV)和GMM估计的阐述非常到位,清晰地指出了在不同情境下应选择哪种估计方法的判断依据。这本书似乎是为那些希望将STATA用于严肃的、发表级别的研究工作的读者准备的,它提供的知识框架是扎实且全面的,足以支撑读者从初学者顺利过渡到能够独立进行复杂数据分析的水平。它是一本能够陪伴我度过多个研究阶段的“百科全书”式的工具书。
评分这本书的排版和装帧确实让人眼前一亮,拿到手里就有一种沉甸甸的质感,封面设计简约而不失专业性,配色沉稳大气,很适合长期放在书架上。初翻阅时,我特别留意了目录结构,它的逻辑梳理得非常清晰,从基础的数据处理概念讲起,逐步深入到复杂的回归分析和面板数据模型,这种由浅入深的编排方式,对于我这种自学统计分析软件的新手来说,无疑是一剂强心针。尤其是前几章对STATA界面和基本命令的介绍,简直是手把手教学,每一个操作步骤都配有清晰的截图和详细的文字说明,让我很快就克服了对软件的初次畏惧感。而且,书中很多例子都是引用了社会科学领域常见的实际案例,这使得抽象的统计理论一下子变得具体可感,我能清晰地看到每一个命令是如何作用于真实世界的数据集上的,而不是停留在空洞的数学公式中。这种实用主义的编写风格,极大地提高了我的学习动力,让我觉得这不仅仅是一本理论参考书,更像是一本随时可以翻阅的实战手册。书中的字体大小和行间距也经过了精心设计,长时间阅读下来,眼睛不容易感到疲劳,这对于需要长时间对着电脑屏幕进行实操学习的人来说,是一个非常人性化的细节考量。
评分从写作风格上来说,这本书展现出一种非常独特的、近乎于“导师”般的语气。它不是那种冷冰冰的参考手册,而是带着一种鼓励和引导的色彩。当解释一些比较绕口的统计概念时,作者会使用一些非常形象的比喻来辅助理解,让人感觉像是坐在一个经验丰富的教授旁边听课一样。比如,在描述假设检验中的I型和II型错误时,书中用了一个非常生活化的例子来解释,一下子就打破了理论的隔阂感。这种亲和力让学习过程变得更加愉快,也有效降低了学习过程中的挫败感。此外,书中对于命令语法的讲解,非常注重细节,比如区分大小写、引号的使用、变量标签的设置等,这些都是新手最容易犯错的地方,作者都用醒目的方式进行了标注和强调。这种细致入微的关怀,使得整本书的阅读体验非常流畅,很少出现“卡壳”的情况。它真正做到了将复杂的技术内容,用最易于接受的方式传达给读者。
评分这本书的配套资源和对数据处理的强调,简直是为我量身定制的。我发现在实际数据分析工作中,数据清洗和预处理往往比运行最终模型要耗费更多的时间。这本书非常体贴地在这方面投入了大量篇幅。它详细介绍了如何使用`merge`, `join`, `reshape`等关键命令来处理复杂的数据结构,比如面板数据和纵向数据。更值得称赞的是,作者似乎预见到了学习者在处理真实世界数据时会遇到的各种“坑”——缺失值(missing values)的处理策略、异常值(outliers)的识别和应对,都有专门的章节进行探讨。而且,书中提供的所有示例数据似乎都是可以直接下载和运行的,这极大地减少了我在寻找或模拟数据上花费的时间和精力。我个人特别喜欢它在数据可视化方面的介绍,它没有仅仅停留在STATA自带的简单图表上,而是深入讲解了如何利用`graph`命令定制出符合出版标准的专业图表,无论是散点图矩阵还是回归系数的森林图,都展示了极高的可定制性,这对于需要撰写学术报告的人来说是无价之宝。
评分我对这本书的另一个深刻印象是它对统计学核心概念的讲解深度。很多介绍STATA操作的书籍往往重操作而轻理论,让人知其然而不知其所以然,但这本书显然避免了这种倾向。它在介绍每一种统计方法(比如t检验、ANOVA、Logit回归)之前,都会用一段非常精炼但又不失严谨的语言来回顾相关的统计学原理,阐述其背后的假设条件和适用范围。这一点对我尤其重要,因为我更希望自己能真正理解“为什么”要使用这个模型,而不是盲目地输入代码。作者在解释多重共线性、异方差这些经典计量经济学难题时,不仅展示了如何在STATA中运行诊断命令,更关键的是,它引导读者思考这些问题对模型解释力的影响,并提供了可行的修正策略。书中对稳健标准误(Robust Standard Errors)的讨论就非常到位,它不仅解释了何时需要使用它,还对比了不同稳健估计方法的细微差别。这种深度,使得这本书能够跨越“初级入门”的阶段,成为一个进阶学习者的有力工具,它要求读者动脑思考,而不是机械地复制粘贴代码。
评分Stata is female whereas SAS is male.
评分Stata is female whereas SAS is male.
评分Stata is female whereas SAS is male.
评分Stata is female whereas SAS is male.
评分Stata is female whereas SAS is male.
相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有