
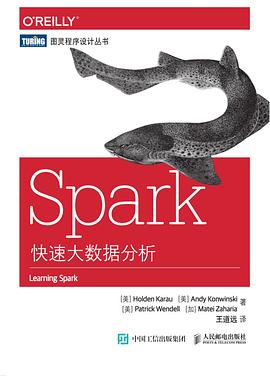
Spark快速大数据分析 pdf epub mobi txt 电子书 下载 2026
- 大数据
- spark
- 数据分析
- Spark
- 计算机
- bigdata
- 数据平台
- 技术
- 大数据
- Spark
- 数据分析
- 快速入门
- 数据处理
- 分布式计算
- 机器学习
- 数据科学
- 高性能计算
- 实时分析

具体描述
作者简介
Holden Karau是Databricks的软件开发工程师,活跃于开源社区。她还著有《Spark快速数据处理》。
Andy Konwinski是Databricks联合创始人,Apache Spark项目技术专家,还是Apache Mesos项目的联合发起人。
Patrick Wendell是Databricks联合创始人,也是Apache Spark项目技术专家。他还负责维护Spark核心引擎的几个子系统。
Matei Zaharia是Databricks的CTO,同时也是Apache Spark项目发起人以及Apache基金会副主席。
目录信息
推荐序 xi
译者序 xiv
序 xvi
前言 xvii
第1章 Spark数据分析导论 1
1.1 Spark是什么 1
1.2 一个大一统的软件栈 2
1.2.1 Spark Core 2
1.2.2 Spark SQL 3
1.2.3 Spark Streaming 3
1.2.4 MLlib 3
1.2.5 GraphX 3
1.2.6 集群管理器 4
1.3 Spark的用户和用途 4
1.3.1 数据科学任务 4
1.3.2 数据处理应用 5
1.4 Spark简史 5
1.5 Spark的版本和发布 6
1.6 Spark的存储层次 6
第2章 Spark下载与入门 7
2.1 下载Spark 7
2.2 Spark中Python和Scala的shell 9
2.3 Spark 核心概念简介 12
2.4 独立应用 14
2.4.1 初始化SparkContext 15
2.4.2 构建独立应用 16
2.5 总结 19
第3章 RDD编程 21
3.1 RDD基础 21
3.2 创建RDD 23
3.3 RDD操作 24
3.3.1 转化操作 24
3.3.2 行动操作 26
3.3.3 惰性求值 27
3.4 向Spark传递函数 27
3.4.1 Python 27
3.4.2 Scala 28
3.4.3 Java 29
3.5 常见的转化操作和行动操作 30
3.5.1 基本RDD 30
3.5.2 在不同RDD类型间转换 37
3.6 持久化( 缓存) 39
3.7 总结 40
第4章 键值对操作 41
4.1 动机 41
4.2 创建Pair RDD 42
4.3 Pair RDD的转化操作 42
4.3.1 聚合操作 45
4.3.2 数据分组 49
4.3.3 连接 50
4.3.4 数据排序 51
4.4 Pair RDD的行动操作 52
4.5 数据分区(进阶) 52
4.5.1 获取RDD的分区方式 55
4.5.2 从分区中获益的操作 56
4.5.3 影响分区方式的操作 57
4.5.4 示例:PageRank 57
4.5.5 自定义分区方式 59
4.6 总结 61
第5章 数据读取与保存 63
5.1 动机 63
5.2 文件格式 64
5.2.1 文本文件 64
5.2.2 JSON 66
5.2.3 逗号分隔值与制表符分隔值 68
5.2.4 SequenceFile 71
5.2.5 对象文件 73
5.2.6 Hadoop输入输出格式 73
5.2.7 文件压缩 77
5.3 文件系统 78
5.3.1 本地/“常规”文件系统 78
5.3.2 Amazon S3 78
5.3.3 HDFS 79
5.4 Spark SQL中的结构化数据 79
5.4.1 Apache Hive 80
5.4.2 JSON 80
5.5 数据库 81
5.5.1 Java数据库连接 81
5.5.2 Cassandra 82
5.5.3 HBase 84
5.5.4 Elasticsearch 85
5.6 总结 86
第6章 Spark编程进阶 87
6.1 简介 87
6.2 累加器 88
6.2.1 累加器与容错性 90
6.2.2 自定义累加器 91
6.3 广播变量 91
6.4 基于分区进行操作 94
6.5 与外部程序间的管道 96
6.6 数值RDD 的操作 99
6.7 总结 100
第7章 在集群上运行Spark 101
7.1 简介 101
7.2 Spark运行时架构 101
7.2.1 驱动器节点 102
7.2.2 执行器节点 103
7.2.3 集群管理器 103
7.2.4 启动一个程序 104
7.2.5 小结 104
7.3 使用spark-submit 部署应用 105
7.4 打包代码与依赖 107
7.4.1 使用Maven构建的用Java编写的Spark应用 108
7.4.2 使用sbt构建的用Scala编写的Spark应用 109
7.4.3 依赖冲突 111
7.5 Spark应用内与应用间调度 111
7.6 集群管理器 112
7.6.1 独立集群管理器 112
7.6.2 Hadoop YARN 115
7.6.3 Apache Mesos 116
7.6.4 Amazon EC2 117
7.7 选择合适的集群管理器 120
7.8 总结 121
第8章 Spark调优与调试 123
8.1 使用SparkConf配置Spark 123
8.2 Spark执行的组成部分:作业、任务和步骤 127
8.3 查找信息 131
8.3.1 Spark网页用户界面 131
8.3.2 驱动器进程和执行器进程的日志 134
8.4 关键性能考量 135
8.4.1 并行度 135
8.4.2 序列化格式 136
8.4.3 内存管理 137
8.4.4 硬件供给 138
8.5 总结 139
第9章 Spark SQL 141
9.1 连接Spark SQL 142
9.2 在应用中使用Spark SQL 144
9.2.1 初始化Spark SQL 144
9.2.2 基本查询示例 145
9.2.3 SchemaRDD 146
9.2.4 缓存 148
9.3 读取和存储数据 149
9.3.1 Apache Hive 149
9.3.2 Parquet 150
9.3.3 JSON 150
9.3.4 基于RDD 152
9.4 JDBC/ODBC服务器 153
9.4.1 使用Beeline 155
9.4.2 长生命周期的表与查询 156
9.5 用户自定义函数 156
9.5.1 Spark SQL UDF 156
9.5.2 Hive UDF 157
9.6 Spark SQL性能 158
9.7 总结 159
第10章 Spark Streaming 161
10.1 一个简单的例子 162
10.2 架构与抽象 164
10.3 转化操作 167
10.3.1 无状态转化操作 167
10.3.2 有状态转化操作 169
10.4 输出操作 173
10.5 输入源 175
10.5.1 核心数据源 175
10.5.2 附加数据源 176
10.5.3 多数据源与集群规模 179
10.6 24/7不间断运行 180
10.6.1 检查点机制 180
10.6.2 驱动器程序容错 181
10.6.3 工作节点容错 182
10.6.4 接收器容错 182
10.6.5 处理保证 183
10.7 Streaming用户界面 183
10.8 性能考量 184
10.8.1 批次和窗口大小 184
10.8.2 并行度 184
10.8.3 垃圾回收和内存使用 185
10.9 总结 185
第11章 基于MLlib的机器学习 187
11.1 概述 187
11.2 系统要求 188
11.3 机器学习基础 189
11.4 数据类型 192
11.5 算法 194
11.5.1 特征提取 194
11.5.2 统计 196
11.5.3 分类与回归 197
11.5.4 聚类 202
11.5.5 协同过滤与推荐 203
11.5.6 降维 204
11.5.7 模型评估 206
11.6 一些提示与性能考量 206
11.6.1 准备特征 206
11.6.2 配置算法 207
11.6.3 缓存RDD以重复使用 207
11.6.4 识别稀疏程度 207
11.6.5 并行度 207
11.7 流水线API 208
11.8 总结 209
作者简介 210
封面介绍 210
· · · · · · (收起)
读后感
打五颗星的怕是要么没看过来装逼的,要么水平太差,没一点基础,居然要凑字数。。。。 居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。...
评分一本入门的好书,讲解了spark的基本情况,讲解了spark core已经内部常用组件,稍显不足的是书中的spark版本较低,有些内容已经在新版本中不适用了 书中对RDD做了非常详尽的讲解,对spark streaming spark sql , MLlib等内容讲解不多 总之,对于入门来说足够了,而且本...
评分我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看...
评分我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看...
评分打五颗星的怕是要么没看过来装逼的,要么水平太差,没一点基础,居然要凑字数。。。。 居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。。。居然要凑字数。。...
用户评价
拿到这本《Spark快速大数据分析》,说实话,我当初是带着一种既期待又忐忑的心情去翻阅它的。我本身是做数据挖掘方向的,对于大数据处理的效率一直非常关注。这本书的封面设计很简洁,但内容排版却出乎意料的扎实。最让我印象深刻的是它对Hadoop生态系统中各个组件之间协作关系的梳理,不是那种浮于表面的介绍,而是深入到了数据流动的细节层面。比如,它详尽地阐述了数据如何在HDFS上存储、如何被MapReduce任务读取,以及Spark RDD演变到DataFrame背后的思想转变。阅读过程中,我发现作者在讲解复杂的分布式计算原理时,总能巧妙地穿插一些实际的案例,比如如何优化一个在大数据集上运行缓慢的SQL查询,或是如何利用广播变量来减少网络IO。这对于我这种希望快速将理论应用于实践的读者来说,无疑是极大的帮助。特别是关于Spark SQL的优化部分,它不仅罗列了各种查询优化技术,还用图示的方式展示了Catalyst优化器的执行路径,让我对“黑盒”下的性能提升有了更直观的认识。整本书的阅读体验是渐进式的,从基础概念的建立,到高级特性的掌握,逻辑链条非常清晰,让人在不知不觉中就构建起一套完整的Spark技术体系认知。
评分我希望找到一本能够跨越不同语言环境,深入理解Spark内核的书籍,而这本《Spark快速大数据分析》在这一点上做得非常出色。它的内容组织结构极其严谨,仿佛在搭建一座精密的桥梁,从一开始的分布式计算模型(如弹性分布式数据集——RDD)开始,稳步提升到更高层次的抽象(如DataFrame和Dataset)。令我惊喜的是,书中对Scala和Python API的覆盖做到了很好的平衡,并没有因为侧重某一种语言而削弱另一种语言读者的体验。书中对于Spark Streaming和Structured Streaming的对比分析尤为精彩,它不仅清晰地指出了批处理与流处理在时间窗口、状态维护上的本质差异,还详细说明了在迁移传统Spark Streaming作业到Structured Streaming时需要注意的关键代码改动点。我记得有一章专门讨论了自定义函数(UDF)的性能陷阱,作者通过对比原生Spark SQL操作符和UDF的执行效率,生动地展示了向量化和代码生成的重要性。这种深入到执行层面的对比,让我对未来代码编写有了更高的标准和更谨慎的态度。
评分老实讲,这本书的厚度让人望而生畏,但真正开始阅读后,那种“内容充实到没有一句废话”的感觉非常强烈。它对Spark生态系统的覆盖广度令人称赞,远超出了对核心计算引擎的介绍。我特别欣赏它在最后几章对高级运维和监控的讲解。在实际生产环境中,光会写代码是远远不够的,如何保证作业的稳定性和可追溯性才是关键。书中详细剖析了Spark UI中各个Metrics的含义,以及如何通过日志文件来诊断那些发生在集群深处的、难以复现的错误。这种从“编写者”视角到“维护者”视角的转换,是很多入门书籍所缺失的维度。它教会了我如何通过观察Driver端的日志来判断Stage是否因为内存溢出而频繁重试,以及如何利用外部监控工具集成Spark的度量体系。这本书的价值在于提供了一套完整的“从零到部署、从优化到维护”的闭环知识体系。阅读完它,我感觉自己不再只是一个Spark API的使用者,而更像是一个能够驾驭整个分布式计算平台的工程师。
评分作为一个偏向于数据科学应用的研究人员,我对算法的实现效率和模型的可扩展性有很高的要求。坦白说,这本书在处理机器学习库MLlib(或现在的ML模块)的应用上,展现出了一种不同于纯粹工程书籍的视角。它没有将MLlib视为一个孤立的工具箱,而是将其置于Spark分布式计算的宏大背景下进行讲解。书中对迭代算法在分布式环境下的收敛性和性能进行了探讨,特别是关于如何高效地在集群间同步模型参数的策略。我发现,作者对如何利用Spark的分布式特性来加速传统机器学习算法的并行化,有着非常独到的见解。例如,在讨论K-Means聚类算法的并行化时,书中不仅仅展示了代码,还分析了在数据量巨大时,如何优化中心点的更新和广播过程,以减少通信开销。此外,书中对GraphX的介绍虽然篇幅相对精简,但其对图计算模型与RDD模型的桥接描述,让我对复杂网络分析的分布式实现有了更清晰的轮廓。这本书为我提供了将前沿算法落地到大规模数据集上的坚实技术基础。
评分这本书的风格,用一个词来形容,就是“硬核且务实”。我之前尝试过几本市面上声称是“快速入门”的教材,结果发现它们要么过于侧重API的堆砌,要么就是对底层机制避而不谈。然而,这本书完全不同。它没有浪费篇幅去讨论那些已经被行业广泛接受的基础配置,而是直奔主题——如何高效地使用Spark来解决实际的工程难题。例如,在讲解Spark的内存管理时,作者并未停留在“堆内”和“堆外”的简单区分,而是详细对比了Tungsten执行引擎与JVM垃圾回收机制之间的博弈,以及如何通过调整存储级别来平衡序列化和反序列化的开销。这种对性能瓶颈的深刻洞察力,是这本书的价值所在。我尤其欣赏它对容错机制的探讨,它不仅解释了RDD的血缘关系如何实现容错,还深入分析了DAG调度器在处理Stage划分和任务重试时的决策逻辑。读完这部分,我立刻回去检查了我之前线上跑批任务中那些不明原因的失败,发现很多都可以归咎于对某个特定算子在数据倾斜时行为预估不足。这本书读下来,更像是在向一位资深架构师请教,收获的不仅是“怎么做”,更是“为什么这样做”。
评分入入门是很好的
评分Spark介绍的很全面,文字通俗易懂,配套代码同时提供python, scala, java 3种语言,方便各类读者学习。看完对Spark有一定了解了。
评分利用两个周末读完了,写得全面且易懂,spark入门的权威首选,第四作者是spark项目的发起人。spark是大数据分析的称手兵器,比hadoop mapreduce不知道高到哪去了,我准备跟它谈笑风生~
评分入门书籍。很薄也很简洁。优点是把spark各个方面都介绍到了,缺点就是太简洁了,都没有很详细的分析个案例。
评分入门好书,后面几章太浅了看看就行。
相关图书


本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.wenda123.org All Rights Reserved. 图书目录大全 版权所有