
具体描述
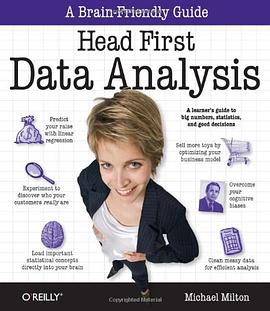
Today, interpreting data is a critical decision-making factor for businesses and organizations. If your job requires you to manage and analyze all kinds of data, turn to "Head First Data Analysis", where you'll quickly learn how to collect and organize data, sort the distractions from the truth, find meaningful patterns, draw conclusions, predict the future, and present your findings to others. Whether you're a product developer researching the market viability of a new product or service, a marketing manager gauging or predicting the effectiveness of a campaign, a salesperson who needs data to support product presentations, or a lone entrepreneur responsible for all of these data-intensive functions and more, the unique approach in "Head First Data Analysis" is by far the most efficient way to learn what you need to know to convert raw data into a vital business tool. You'll learn how to: determine which data sources to use for collecting information; assess data quality and distinguish signal from noise; build basic data models to illuminate patterns, and assimilate new information into the models; cope with ambiguous information; design experiments to test hypotheses and draw conclusions; use segmentation to organize your data within discrete market groups; visualize data distributions to reveal new relationships and persuade others; predict the future with sampling and probability models; clean your data to make it useful; and, communicate the results of your analysis to your audience. Using the latest research in cognitive science and learning theory to craft a multi-sensory learning experience, "Head First Data Analysis" uses a visually rich format designed for the way your brain works, not a text-heavy approach that puts you to sleep.
作者简介
Michael Milton将自己的大半职业生涯献给了非盈利机构,帮助这些机构解析和处理从赞助人那里收集来的数据,提高融资能力。Michael Milton拥有新佛罗里达学院哲学学位及耶鲁大学宗教伦理学学位。多年来,他博览群书,这些书籍虽字字珠玑,却枯燥乏味; 蓦然抬首, 深入浅出(Head First)系列图书让他眼前一亮,他欣然抓住机会,写出了这本同样字字珠玑,兼振奋人心的书。
走出图书馆和书店,人们会看到他在跑步,摄影,以及亲手酿制啤酒。
目录信息
读后感
挺惭愧的,这本书2017年买的时候,读了一遍,但是朋友推荐这本书时,却想不起来书中的内容,这次又重读一遍,发现确实是本好书,不仅从数据分析专业领域,而且从思维学习上,都让人颇有收获。作者通过类似实际的案例(包括具体的人和遇到的具体问题)讲述不同的数据分析方法,...
评分《深入浅出数据分析》是美国O’REILLY出版社的“深入浅出”系列之一,以类似“章回小说”的活泼形式,穿插插图,对话,问答,作业,生动地向读者展现优秀的数据分析人员应知应会的统计学入门技术: 首先是数据分析的四个基本步骤 1、确定问题(找到关键的人,问对关键的问题,...
评分这真的只是一本超级入门书,主要让新人了解一些数据分析的应用、思路和方法吧。 按照每一章的内容,我总结了一下(好像跟章节标题差不多:-)) 1. 假设是否正确 2. 细分,对照组实验 3. 线性规划 4. 多因素对比及展现 5. 假设证伪,可能性星级评分 6. 贝叶斯 7. 量化可能性及...
评分This is my first time reading the book of Orielly’s Head First series. This series is noted for its quite brain-friendly style which based on brain and cognitive science. The authors use many colloquial expressions, funny pics and dialogues in order to mak...
评分看到很多书评说书写的浅,只是简单介绍了一些基本统计的方法。我却不这么认为。 虽然和国内的统计学教程比起来,这本书没有那么多公式和理论的完整介绍和推导,但其中对于统计的基本原理以及统计问题的来源场景介绍的非常通透,可以说是国内著作所没有的。 我看的是英文版,...
用户评价
这本书的叙事方式简直是一场灾难,它试图用一种非常轻松诙谐的口吻来讲解严肃的主题,结果就是内容被切割得支离破碎,逻辑链条时常断裂。我感觉作者在力图避免使用任何专业术语,但这种过度“口语化”的表达反而让原本清晰的流程变得模糊不清。比如,在介绍数据预处理的步骤时,它会突然插入一个关于作者个人生活的小故事,这个故事和数据处理的关联性微乎其微,读到关键的步骤时,读者不得不花时间去分辨哪些是重点,哪些是“跑题”的闲聊。很多关键概念的定义都隐藏在长篇大论的对话或比喻中,你必须仔细地、逐字逐句地去挖掘,才能找到那个核心的定义。这种阅读节奏非常耗费精力,我常常读完一章后,合上书本,发现自己脑子里留下了一堆零散的、不成体系的概念,而不是一个清晰的数据分析框架。它更像是一系列零碎的“灵感笔记”的集合,而非一本结构严谨的教程。
评分这本书在选择讨论的工具集方面,表现出一种令人费解的保守倾向。尽管数据分析领域的技术栈发展日新月异,新的库和框架层出不穷,这本书似乎停留在好几年前的技术标准上。它反复强调使用那些已经被更高效、更现代的工具所替代的传统方法。当我尝试将书中的示例代码应用到我当前工作环境中的较新版本库时,遇到了大量的兼容性问题,很多函数已经被弃用或修改了参数。这使得我不得不花费大量时间去搜索引擎上查找“如何在最新版本中实现书里讲的那个功能”,这完全偏离了跟随教程学习的初衷。一本面向“分析”的指南,如果不能与时俱进地介绍当前行业主流、效率最高的工具,其时效性和参考价值就会大打折扣。它更像是一份关于“历史数据分析方法”的文档,而不是一本面向未来的实践指南。
评分最让我感到失望的是,这本书在“如何构建一个完整的数据分析项目”这一环节的处理上,几乎是缺失的。它将数据分析拆解成了许多孤立的模块——数据采集、数据清洗、模型选择、结果呈现——并分别对这些模块进行了讲解。然而,真实世界的数据分析是一个连贯且循环的过程,需要对各个阶段之间的相互影响有深刻的理解。这本书从未提供一个端到端(End-to-End)的完整案例,让我们看到一个原始数据文件是如何一步步转化为商业决策的。所有的例子都是片段式的、高度简化的“沙盒”环境。这造成了一个严重的后果:读者虽然学到了一些零散的技能点,但完全不知道如何将这些技能串联起来,去应对一个实际的、脏乱差的项目需求。它教会了你如何使用螺丝刀和扳手,却从不告诉你如何组装一台完整的机器。这种对整体流程的忽视,使得这本书的教育价值远低于一本结构化的项目实战手册。
评分我最近入手了一本据说非常棒的数据分析入门书籍,但读完之后,我得说,它真的非常侧重于理论的阐述,几乎没有提供任何实际操作的案例或者可以跟着敲的代码示例。书里花了大量的篇幅来讲解统计学的基本概念,比如正态分布、假设检验,这些知识点本身是重要的,但对于一个渴望快速上手、进行实际数据清洗和可视化的读者来说,简直就是一场折磨。我期待的是那种“手把手教你用Python/R解决实际问题”的风格,结果拿到的是一本厚厚的教科书,里面的数学公式多到让人头皮发麻,而且作者似乎认为读者都具备深厚的数理背景。每次读到需要理解一个复杂模型的推导过程时,我都要反复查阅很多其他的资料来辅助理解,这本书完全没有起到引导者的作用。如果你的目标是深入研究数据分析背后的数学原理,或许它合适,但对我这种想尽快将数据转化为洞察的实践者来说,它提供的实用价值非常有限,阅读体验更像是在上枯燥的大学高数课,而不是学习一门应用技术。
评分从装帧设计和排版上看,这本书试图营造一种“反传统”的视觉风格,这本无可厚非,毕竟“Head First”系列一直都有这个特点。然而,在这个特定的主题上,这种设计带来的负面影响被放大了。大量的插图、气泡对话框和不同字体颜色的运用,虽然在理论上是为了提高阅读兴趣,但在我看来,它们极大地干扰了对信息层级的判断。当我试图快速定位某个关键算法的输入输出格式时,我不得不穿梭于各种夸张的漫画和高亮标记之间,很多时候,那些用于强调的图示反而成为了阅读的障碍。信息的密度被刻意稀释,使得整本书的篇幅显得过于臃肿,但核心知识点的承载量却非常低。对于需要频繁查阅特定技术细节的读者来说,这种设计极大地降低了工具书的可用性。它看起来像一本有趣的杂志,但做不成一本高效的学习手册。
评分headfirst 风格
评分数据分析的故事书
评分十分适合做饭的间隙里看。
评分数据分析的故事书
评分歪果仁的书写的真有意思,就是内容略简单了些~